分析基盤をAthenaからBigQueryへノーコードで移行した話
この記事はmikan Advent Calendar 2023の24日目の記事です。
こんにちは。株式会社mikanでPlatform Engineeringチームのリーダーをしております。@hoshitocat です。Platform Engineeringチームは最近できたチームですが、その取り組み内容についてはまた後ほどご紹介できればと思っています。
昨日はQAチームのchiakiさんによる、 「テスト自動化で試行錯誤した話」でした。QAの自動化に取り組みたいと思っている方や、QAコスト削減方法に悩んでいる方はぜひ読んでみてください!
なお、mikan Advent Calendar 2023の他の記事は下記のリンクからご覧ください。
はじめに
mikanでは行動分析をAthenaで行っていましたが、現在は、分析上の課題感からBigQueryへの移行を完了させ、ほとんどの分析がBigQuery上で完結できるようになりました。
分析しやすい基盤構築をしたいと思っている人の参考になればと思います。
これまでの分析基盤の課題
クライアントから送信された行動ログがS3に蓄積され、それをAthenaを使って分析するということをやっていました。
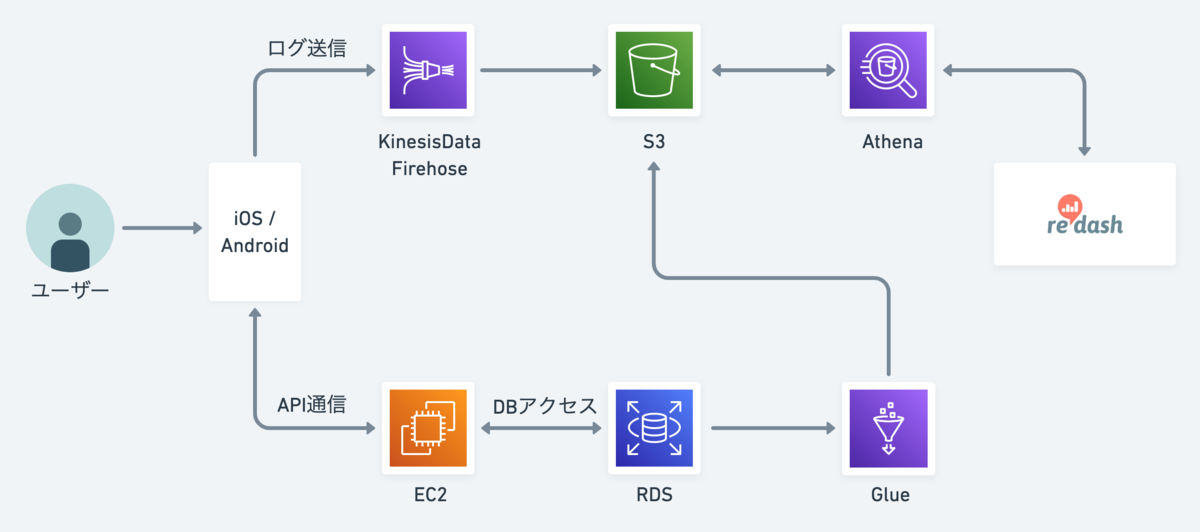
生ログデータを対象にSQLを実行していたため、膨大なデータから必要なログを抽出し、クエリでコネコネして集計するということをやっていました。分析チームによる秘伝のタレがあり、それを分析したい人が使い回している状況でした。そのため、
- 普段よく使うデータを算出するにも秘伝のタレを使うことになり、クエリが複雑化する
- 複雑化したクエリを使い回しているため、分析の難易度が高い
- 生ログを毎回集計しているため、集計コスト(金額と時間)が高い
などの課題がありました。
mikanの分析基盤の歴史についてはこちらの記事で紹介されているので、興味のある方はぜひ!
BigQuery利用への意思決定
今回の課題を解決するためには、生ログからの直接集計を止めれば良いので、よく使うデータをまとめた中間テーブルを作成することができれば解決できそうです。
運用とセットで考えないといけないので、要件としては以下を満たすことができれば良さそうと考えました。
- 分析チームメンバーが管理者となって中間テーブルの作成、管理することができる
- 分析者(これは分析したい人全員が対象となるため分析チーム以外も含む)は中間テーブルを使って分析する
さらに追加要件として、分析チーム専任のエンジニアをアサインできないため、作成や管理方法をできるだけ簡単にする必要がありました。
具体的には、普段使っているSQLを使って中間テーブルを作成することができると良さそうでした。
Glueを使ってみるが断念
まず最初に考えたのが、現状の構成のまま中間テーブルを作れないか?ということでした。そこで、AWS Glueを使って生ログデータを加工し、中間テーブルを作ることができそうだったので検証していました。
しかし、mikanの分析データを扱う際にうまくPushdown Predicatesが機能せず、ETL処理に時間がかかりすぎてTimeoutしてしまうという問題がありました。
パーティションの切り方に問題がありそうだったので、Lambdaでそこを修正した上でGlueを使うことも考えたのですが、Lambdaの運用コストを考えると、今の分析チームでは運用コストが高すぎるとなり、一旦保留となりました。
AthenaではなくBigQueryを使うという選択肢
そうこうしている中、弊社の分析メンバーでBigQueryを使って分析基盤を運用した経験があるメンバーから、そっちだったら中間テーブルとか諸々の運用が楽なのにな〜という話がでました。
特にAthenaを使いたいという強い理由はなかったので、S3の行動ログを分析できれば良かったので視野を広げて調査してみると、STSを使えば、S3からGoogle Cloud Storage(GCS)へデータ移行を完全マネージドで実現することができそうなことがわかりました。
検証を進めていくうちにGCSへの移行は割と簡単かつ低コストでできることがわかりました。
料金については以下を参照して下さい。
STS以外にも
のようなものが使えそうでした。
詳しくは以下の記事がわかりやすかったです。
STSとDataprepの利用
歴史的経緯から、弊社の生ログデータには
- すでに使っていない古い要素
- duid(昔のユーザを一意に特定するためのもの)
- tutorial_category(ユーザに入力してもらう学習目的。今は別のものに置き換わっている)
- 不正なデータ
- uid(ユーザを一意に特定するためのID)が含まれていないもの
- timestampの無いもの
などのように不要なデータや不正なデータが混ざっています。そのため、今回データを移行する段階で、データのクレンジングや加工処理を挟むことができれば、その問題も解決できると考えました。
- 例
- すでに使っていない古い要素 → 削除
- 不正なデータ
- uidが含まれていないもの → 空文字列で追加 or 集計対象に含めないなら削除
- timestampがないもの → PartitionからTimestampを擬似的に生成(完全に正確なTimestampとはいえないが限りなく近いものになるはず)
BigQuery OmniやBigQuery Data Transfer Serviceなどを利用するよりも、一旦STSを使ってGCSへデータを移行できれば、DataFlowなどを使えば簡単に加工処理などできるため、そうすることとしました。
最終的に、STSでS3からGCSへ生ログのデータを単純に移行し、GCSからBigQueryのETLをDataprepを使って行うことにしました。
Dataprepを使う理由としては、運用コストと実装コストが低いことにあります。DataprepはGUI上で操作するだけで、DataFlowのジョブを作成できるので、非常に簡単に実装することができました。
実際にやったこと
STSを使ってS3のデータをGCSへ移行する
行動ログはクライアントからS3へ蓄積する仕組みがあり、それは今回変わらないので最新のデータはS3へこれからも吐き出されることになります。
そのため
- 過去の行動ログデータを移行する単発のJob
- S3へデータが書き込まれたらGCSへ同期するJob
の2つが必要でした。
過去の行動ログデータを移行する単発のJobに関しては、数百GBあるデータも20分程後で移行が完了し、めちゃくちゃ高速でした。
S3へデータが書き込まれたらGCSへ同期するJobに関しては、イベントドリブン転送というものがあり、それを利用することでほぼリアルタイムに同期することができるようになります。
Dataprepを使ってGCSからBigQueryへデータを格納する
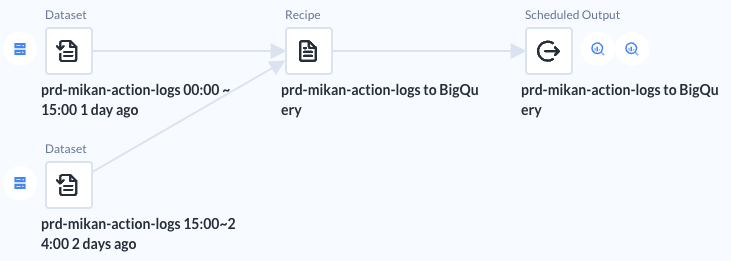
Jobの作成は以下のようなGUI上でぽちぽちするだけで作成することができます。DatasetのPathには日付や正規表現を利用することができるので、GCS上のファイルパスやファイル名を工夫すれば、特定のデータだけを抽出することが簡単にできます。
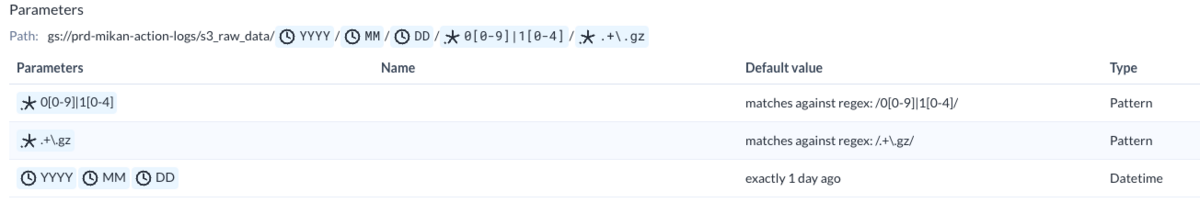
また、Plansというものがあり定期実行することもできます。こちらもGUI上で設定でき、Jobの実行状況(実行中、成功、失敗の3種類)ごとにSlack通知などすることもできます。
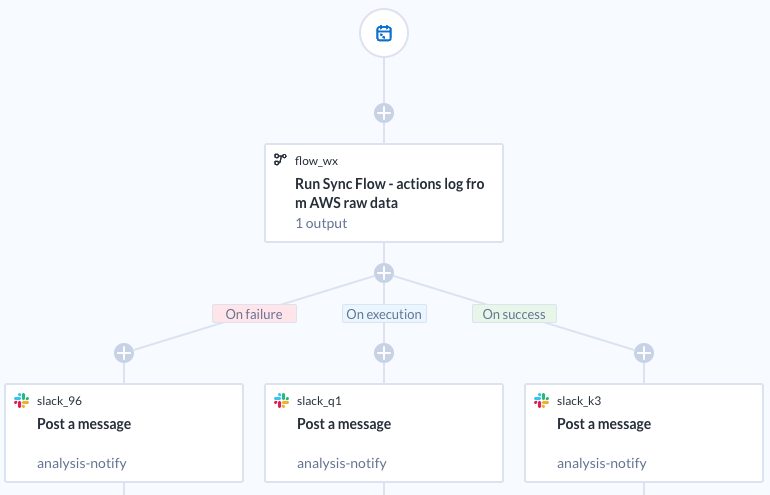
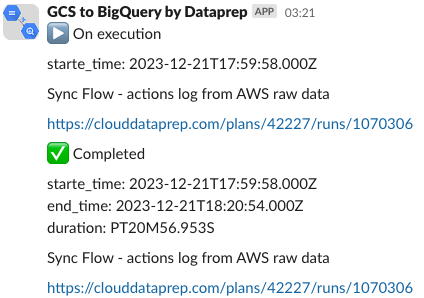
運用
今回作成したもので、BigQueryで生ログデータを集計することができるようになりました。中間テーブルの作成は、この生ログデータを元にDataformを使って中間テーブルの作成をしています。数十分程度かかっていた分析が数秒で終わるようになったりと現時点でかなりの恩恵を得られています。
Dataformの活用に関しては、分析チームがまとめてくれると思いますので乞うご期待ください。
まとめと今後の展望
今回はSTSとDataprepを使って、S3にある行動ログをAthenaで集計していたものを、BigQueryで集計できるようにするところまでをノーコードで実現する方法について紹介しました。
分析基盤に十分にエンジニアリソースをかけることができない弊社でも簡単に実現することができたので、分析にお困りの方は検討してみると良いかもしれません。
今後の展望としては以下のようなことに取り組んでいきたいと思っています。
- STSを使わずに直接クライアントから行動ログをGCSへ格納する
- データの民主化が実現する一方でBigQueryへの課金額が心配なため、制限を設けるなどの対策をする
- サービスに利用しているデータストアと行動ログとを結合して分析できるようにする
おわりに
ここまで長くなりましたが、AthenaからBigQueryへの移行をかなり低コストに実現できたと思っています。今回の取り組みで、分析基盤を整えることで分析チームの日々の業務改善にも繋げられたので、同じ課題を抱えている方の参考になれば幸いです。
現在、mikanのバックエンドチームは私含め2名ということで、バックエンドエンジニアを絶賛募集中です。
今回は分析基盤の紹介になりましたが、インフラからAPIの運用など日頃から幅広い責務を担っています。
まだまだ、これから改善が必要なところがたくさんありますが、技術の意思決定にもガッツリはいっていけるフェーズかと思いますので、興味のある方は、まずはお気軽に一回お話しさせていただければと思います!
mikanQT - 英語学習教材データの再設計
この記事はmikan Advent Calendar 2023の5日目の記事です。
この記事では、mikanが提供している教材学習システムの裏側について触れていますので、ご興味があれば読んでいただけますと嬉しいです。
なお、mikan Advent Calendar 2023の他の記事は下記のリンクからご覧ください。
mikanQTについて
mikanでは、様々な学習教材が掲載されており、例えばTOEIC®対策の教材や、英検®対策の教材などたくさんの種類があります。
TOEIC®はPart1〜Part7まで、英検®は短文の語句空所補充や長文の内容一致選択、会話の内容一致選択など、多くの問題形式が存在し、試験対策用の学習教材は特に、それらの問題形式に基づいてコンテンツが用意されていることがほとんどです。
mikanでは問題形式のことをQuestionTypeと呼んでおり、mikanの学習体験をベースにQuestionTypeを再設計したものがmikanQTです。
なぜQuestionTypeを再設計するのか
Contents QuestionTypeのツラミ
説明の都合上、TOEIC®のPart1のようなQuestionTypeを、便宜的にContents QuestionTypeとします。
これまではContents QuestionTypeをそのままの形式で利用してAPIからデータを返していました。
具体例がないと理解しづらいと思いますので、実際の入稿フローの一部を紹介します。
入稿
まず、書籍のデータをAPIで扱えるようにするため(=つまりDBに格納するため)に、入稿データを作ります。
入稿シートがあるので、Contents QuestionTypeが持つフィールド(以下、Attribute)に割り当てていきます。

各カラムの4行目はAttributeのキーに対応しており、これらのキー名とともに、値がDBに保存されます。
API
APIはDBのデータを取り出し、必要に応じてデータを加工してレスポンスします。
for _, attr := range attrs {
        var parsedAttr domain.QuestionAttribute
        typeID := domain.QuestionTypeID(types[attr.QuestionID])
        switch typeID {
        case domain.QUESTION_TYPE_TOEIC_PART_1:
            a, err := i.parseTOEICPart1Attr(attr)
            if err != nil {
                return nil, err
            }
  // ...
}
加工処理の中では、音声や画像などのアセットのURLを作る処理や、部分的なHTMLを作るためのテンプレートパース処理など、Contents QuestionTypeに応じた細かなプログラムが書かれています。
最終的に、QuestionAttributeとしてまとめてデータを返します。
type QuestionAttribute struct {
    QuestionID string `json:"question_id"`

    /* 音声系attribute */
    /* 基本のHTMLタグのみ対応. 詳細の表示ロジックは各プラットフォーム依存 */
    AudioTextEN            string `json:"audio_text_en,omitempty"`
    AudioTextJA            string `json:"audio_text_ja,omitempty"`
    AudioSentenceEN        string `json:"audio_sentence_en,omitempty"`
    AudioSentenceJA        string `json:"audio_sentence_ja,omitempty"`
    AudioContextSentenceEN string `json:"audio_context_sentence_en,omitempty"`
    AudioContextSentenceJA string `json:"audio_context_sentence_ja,omitempty"`
    /* HTML対応attribute */
    AudioContextSentenceHTMLEN string `json:"audio_context_sentence_html_en,omitempty"`
    AudioContextSentenceHTMLJA string `json:"audio_context_sentence_html_ja,omitempty"`
    /* 音声ファイルattribute */
    /* URL */
    AudioURL         string `json:"audio_url,omitempty"`
    ResultAudioURL   string `json:"result_audio_url,omitempty"`
    CombinedAudioURL string `json:"combined_audio_url,omitempty"`
    /* ファイル名 */
    AudioFilename         string `json:"audio_filename,omitempty"`
    ResultAudioFilename   string `json:"result_audio_filename,omitempty"`
    CombinedAudioFilename string `json:"combined_audio_filename,omitempty"` // 非階層のみ: 通常のリスニング問題音声と解答のための空白時間を含めた音声ファイル

    /* Listening & Reading共通 */
    /* 基本のHTMLタグのみ対応. 詳細の表示ロジックは各プラットフォーム依存 */
    BlankedSentenceEN               string `json:"blanked_sentence_en,omitempty"`
    ContextSentenceEN               string `json:"context_sentence_en,omitempty"`
    ContextSentenceJA               string `json:"context_sentence_ja,omitempty"`
    Description                     string `json:"description,omitempty"`
    DescriptionEN                   string `json:"description_en,omitempty"`
    DescriptionJA                   string `json:"description_ja,omitempty"`
    Explanation                     string `json:"explanation,omitempty"`
    SentenceEN                      string `json:"sentence_en,omitempty"`
    SentenceJA                      string `json:"sentence_ja,omitempty"`
    RecommendedAnswerSecondsCaption string `json:"recommended_answer_seconds_caption,omitempty"` // 階層&Readingのみ: recommended_answer_secondsの引用(出典)元
    /* HTML対応attribute */
    ContextSentenceHTMLEN  string `json:"context_sentence_html_en,omitempty"`
    ContextSentenceHTMLJA  string `json:"context_sentence_html_ja,omitempty"`
    ExplanationHTML        string `json:"explanation_html"` // すべての問題タイプにおいて非空文字を返しているため、omitemptyを外している
    SentenceHTMLEN         string `json:"sentence_html_en,omitempty"`
    SentenceHTMLJA         string `json:"sentence_html_ja,omitempty"`
    SentenceHTML           string `json:"sentence_html,omitempty"`
    SentenceCommentaryHTML string `json:"sentence_commentary_html,omitempty"`
    // SentenceCommentaryHTMLを分割するために以下2つを定義
    // 詳細: https://www.notion.so/mikantechnology/Html-8892a76ec90a4ad6ba55bef569070ed3
    SentenceCommentaryEN string `json:"sentence_commentary_en,omitempty"`
    SentenceCommentaryJA string `json:"sentence_commentary_ja,omitempty"`
    ResultSentenceHTML   string `json:"result_sentence_html,omitempty"`
    ResultSentenceHTMLEN string `json:"result_sentence_html_en,omitempty"`
    ResultSentenceHTMLJA string `json:"result_sentence_html_ja,omitempty"`
    VocabularyHTML       string `json:"vocabulary_html"`

    /* 解答系attribute */
    /* 基本のHTMLタグのみ対応. 詳細の表示ロジックは各プラットフォーム依存 */
    AnswerChoice                                string   `json:"answer_choice,omitempty"`
    AnswerChoicesCommaSeparatedTextEN           string   `json:"answer_choices_comma_separated_text_en,omitempty"`
    AnswerChoicesCommaSeparatedTextJA           string   `json:"answer_choices_comma_separated_text_ja,omitempty"`
    AnswerChoicesEN                             []string `json:"answer_choices_en,omitempty"`
    AnswerChoicesJA                             []string `json:"answer_choices_ja,omitempty"`
    AnswerListSentenceHTML                      string   `json:"answer_list_sentence_html,omitempty"`
    AnswerRearrangedChoicesCommaSeparatedTextEN string   `json:"answer_rearranged_choices_comma_separated_text_en,omitempty"`
    AnswerRearrangedChoicesCommaSeparatedTextJA string   `json:"answer_rearranged_choices_comma_separated_text_ja,omitempty"`
    AnswerRearrangedChoicesEN                   []string `json:"answer_rearranged_choices_en,omitempty"`
    AnswerRearrangedChoicesJA                   []string `json:"answer_rearranged_choices_ja,omitempty"`
    AnswerSentencePartialHTML                   string   `json:"answer_sentence_partial_html,omitempty"`
    AnswerSentencePartialHTMLEN                 string   `json:"answer_sentence_partial_html_en,omitempty"`
    AnswerSentencePartialHTMLJA                 string   `json:"answer_sentence_partial_html_ja,omitempty"`

    /* 推奨時間 */
    RecommendedAnswerSeconds uint64 `json:"recommended_answer_seconds,omitempty"` // 非階層のみ: Readingのときは単なる推奨解答時間になるが、Listeningのときは `combined_audio` の再生時間となる
    /* 複数要素 */
    *QuestionMultiattribute
}
クライアント
クライアントは、必要なデータをレスポンスから取り出してViewに描画したり、回答のロジックを作ったりしています。
public struct Part1Question: ExamQuestionProtocol, Codable, Equatable {
    public let id: String
    public let orderNumber: Int
    public let displayId: String
    public let audioUrl: String
    public let imageEntities: [String]
    public var imageUrl: String {
      return imageEntities.first!
    }
    public let explanationHtml: String
    public let choices: [Exam.Choice]
    public let title = ""
    public let recommendedAnswerSeconds: Int
    public let combinedAudioUrl: URL
    // ...
}


お気づきの方もいらっしゃると思いますが、APIが持つモデルQuestionAttributeの各フィールドが、omitemptyとなっています。
これは、AttributeがEAV(Entity Attribute Value)パターンでテーブル設計されていることが理由です。
おそらく、教材によって同じ問題形式でも異なる表現方法があり、模索しながら抽象化していく経緯があって、スキーマを柔軟に変更できるEAVを採用したのだと推察しています。
実際に、このようなデータがテーブルに格納されています。

上記の表を取得するためには下記のSQLを発行する必要があります。
SELECT
    q.id,
    qat. `name`,
    qa. `value`
FROM
    questions q
    JOIN question_attributes qa ON qa.question_id = q.id
    JOIN question_attribute_types qat ON qa.question_attribute_type_id = qat.id
    JOIN question_units qu ON q.question_unit_id = qu.id
    JOIN chapters c ON qu.chapter_id = c.id
    JOIN books b ON c.book_id = b.id
WHERE
    b.id = "01GHAZTZTAREG4SDYK9BJ7QJ20";
EAVを利用することで、以下のようなデメリットが発生していました。
- 特定のAttributeへのNOT NULLやデータサイズなどの制約を付与できない
- Contents QuestionTypeに必須なキーの入稿漏れに気づけない
- 不必要に大きいデータを入稿できてしまう
- データを取得するために多くのJOINが必要で、SQLが複雑になる
- 入稿ミス時の状況確認や、APIで不具合が発生したときの調査が大変
- 不整合の検知が難しい
- キー名を間違えて入稿するなど
Contents QuestionTypeによっては、必要ないAttributeもまとめてEAVとして管理している関係でNullableな要素が多く、それをQuestionAttributeとして一つのモデルで表現したことで、クライアントのデコードエラーを引き起こしたり、入稿ミスや不具合発生時の調査を遅らせたりしていました。
さらに、提携教材が増えていくとContents QuestionTypeも増えていきます。
Contents QuestionTypeに必要なAttributeはどれで、オプショナルなAttributeはどれなのか、管理がどんどん難しくなっていきます。
各Contents QuestionTypeの型定義がないのも要因の一つでした。
また、例えば「ほとんどPart1と似た形だが微妙に異なるフィールドが必要」な教材を掲載したくなったときに、Contents QuestionTypeの再設計及び実装が必要になります。

解決策としてのmikanQT
ここまでで、Contents QuestionTypeをAPIでそのまま扱ってしまうと、下記の問題があることを説明しました。
- Contents QuestionTypeごとに必要なAttributeとオプショナルなAttributeの区別が難しかった
- Attributeの微妙な違いで、新たにContents QuestionTypeを増やさなければならないケースがあった
EAVはともかく、教材データをもとにして入稿データを作成するところまでは良いのですが、それをそのままの形でAPIが利用していたことが問題だったため、mikanの学習体験を起点にしたQuestionTypeを作成することにしました。その理由を述べるには、既存のContents QuestionTypeの特徴を説明する必要があります。
TOEIC Part 5や短文の語句空所補充を例に挙げます。


これまでのContents QuestionTypeの設計の場合、問題文や解説を構成する要素が教材や試験の問題形式によって異なっていたため、別のContents QuestionTypeとして設計されていました。
これらをmikanでの学習体験から考えると、問題文があり、4択で解答ができて、解説を見れるという体験は共通になっています。
つまり、それらの体験を満たせる型を定義すれば、上述した問題をひとまず解消することができます。
続いて、mikanQTの具体例を見ていきます。
まずはGo言語の構造体の定義の例を以下に示します。
type StringComponent struct {
    Text string              `json:"text"`
    Type StringComponentType `json:"type"` // クライアントが表示方法を分岐させるためのフィールド
}

const (
    StringComponentTypePlain       StringComponentType = "plain"
    StringComponentTypePartialHTML StringComponentType = "partial_html"
    StringComponentTypeHTML        StringComponentType = "html"
    StringComponentTypeImageURL    StringComponentType = "image_url"
)

type QuestionComponentReadingUnitChoices struct {
    Result   *QuestionComponentReadingUnitChoicesResult `json:"result"`
    Sentence *StringComponent                           `json:"sentence"`
    Choices  []*QuestionChoice                          `json:"choices"`
}

type QuestionComponentReadingUnitChoicesResult struct {
    Headline *StringComponent `json:"headline"`
    Sentence *StringComponent `json:"sentence"`
}
似たような型が並んでいて少々見づらいのですが、QuestionAttributeに比べると、問題文、選択肢、解説画面など、学習に必要な要素をシンプルに表現できているかと思います。
mikanではクライアントとの通信の一部にGraphQLを利用しているため、GraphQLスキーマも定義しています。
type Question implements Node {
  id: ID!
  displayId: String!
  orderNumber: Int!
  components: QuestionComponents!
}

union QuestionComponents =
    QuestionComponentReadingUnitChoices
  | QuestionComponentReadingChoices
  | QuestionComponentListeningUnitChoices
  | QuestionComponentListeningChoices

type QuestionComponentReadingUnitChoices {
  result: QuestionComponentReadingUnitChoicesResult!
  sentence: StringComponent
  choices: [QuestionChoice!]!
}

type QuestionComponentReadingUnitChoicesResult {
  headline: StringComponent!
  sentence: StringComponent!
}
これにより、クライアントとしてもcomponentsの__typenameを見ることで適切なUIに切り替えることができます。
Contents QuestionTypeは学習体験ベースでmikanQTに集約され、オプショナルの問題もスキーマレベルで解消されています。
進め方
実際にmikanQTを導入していくために、いくつかのステップが必要になります。
- 既存のContents QuestionTypeの洗い出し
- クライアントの画面と、利用しているAttributeの一覧をマッピングする
- mikanQTのGraphQLスキーマを定義する
- Contents QuestionTypeごとにマイグレーションスクリプトを書く
- マイグレーションスクリプトを実行する
- リゾルバを実装する
1. 既存のContents QuestionTypeの洗い出し
まずは、mikanで取り扱っているContents QuestionTypeを洗い出す必要があります。
これはContents QuestionTypeを管理しているテーブルからデータを取得するだけで完了となります。
2. クライアントの画面と、利用しているAttributeの一覧をマッピングする
ここが一番辛い作業です。
APIで定義したAttribute名とクライアントで利用しているモデルのフィールド名に差分があったり、APIが返したデータをクライアントでさらに加工している部分があったりと、紐解くのが大変でした。
型定義書もなく、APIはほぼオプショナルで返してしまっているので、クライアントチームに多大なご協力をいただきContents QuestionTypeごとに利用しているAttributeを洗い出していただきました。

各Contents QuestionTypeごとにAttributeを洗い出したら、それぞれ似たものを集約できないかを考えてまとめていきます。
現時点では、4種類に分類することができました。

3. mikanQTのGraphQLスキーマを定義する
必要なmikanQTと、それに付随するAttributeが判明したので、GraphQLスキーマ、Goの構造体を定義していきます。
実際のコードの一部は上述したたため、割愛します。
4. Contents QuestionTypeごとにマイグレーションスクリプトを書く
生のAttributeからAPIレスポンス用にデータを加工する処理がContents QuestionTypeごとに書かれているため、APIの見通しが悪くなっていました。
この問題に対し、あらかじめデータを加工した状態でデータを持っておけば、APIの仕事が減って見通しも良くなると考え、APIが行っていた処理をマイグレーションスクリプトとして実装し、加工済みデータを保存しておくことにしました。
EAVのままでは多段のJOINが必要という問題もあったため、一旦はMySQLのテーブルにJSON型で保存することでJOINなしでデータを引けるようにしました。
JSON型を利用しても、データ型や必須属性を制約としてつけられないといったEAVのデメリットはそのままですが、マイグレーションスクリプト上でも上述した構造体を参照することで型を担保しています。
また、JSON型を利用した際のパフォーマンスの懸念がありますが、SQLでJSON関数を呼び出すこともなく、そのままUnmarshalされるのでDBのCPU負荷としては今のところ問題ありません。
※ただし、巨大なJSONを持つレコードがあるとクエリ応答がかなり遅くなるケースもあることが分かっているため、こちらはまた対処したいと思っています。
QuestionAttributeを返すAPIのレスポンスと、マイグレーションスクリプトによって作成されたJSONが一致することを確認しながら作業を進めました。
5. マイグレーションスクリプトを実行する
4で作成したスクリプトを、教材ごとに実行していきます。
いきなりすべての教材に対して実行せずに、部分的に実行していくことでリスクを減らします。
マイグレーションと言っても、既存のデータをもとに加工済みデータを作成し、新たなテーブルに保存しているだけなので、既存データへの変更はありません。
6. リゾルバを実装する
mikanQTのデータはJSON型で表現されているため、単純にDBからSELECTしたものをUnmarshalしていきます。
Unmarshal後は、Validメソッドを呼んでバリデーションをおこないます。
(バリデーションはUnmarshallerとして内部でコールしても良かったかもしれません。)
type QuestionComponent interface {
    IsQuestionComponent()
  Valid() error
}

func parseQuestionComponents[T QuestionComponent](raw json.RawMessage) (*T, error) {
    var components T
    err := json.Unmarshal(raw, &components)
    if err != nil {
        return nil, err
    }
  if err = components.Valid(); err != nil {
        return nil, err
    }
    return &components, nil
}
ジェネリクスを利用しているため型を渡す必要があるのですが、型は作業手順2で作成したContents QuestionTypeとmikanQTのマッピングを利用して判定します。
func ParseMikanQuestionTypeFromQuestionTypeID(questionTypeID string) (QuestionTypeID, error) {
    switch questionTypeID {
    case QUESTION_TYPE_TOEIC_PART_1.String(), QUESTION_TYPE_TOEIC_PART_2.String(), QUESTION_TYPE_LISTENING_CHOICES.String():
        return QUESTION_TYPE_LISTENING_CHOICES, nil
    case QUESTION_TYPE_TOEIC_PART_3.String(), QUESTION_TYPE_TOEIC_PART_4.String(), QUESTION_TYPE_LISTENING_UNIT_CHOICES.String():
        return QUESTION_TYPE_LISTENING_UNIT_CHOICES, nil
    case QUESTION_TYPE_TOEIC_PART_5.String(), QUESTION_TYPE_READING_CHOICES.String():
        return QUESTION_TYPE_READING_CHOICES, nil
    case QUESTION_TYPE_TOEIC_PART_6.String(), QUESTION_TYPE_TOEIC_PART_7.String(), QUESTION_TYPE_READING_UNIT_CHOICES.String():
        return QUESTION_TYPE_READING_UNIT_CHOICES, nil
    }
    return "", fmt.Errorf("ParseMikanQuestionTypeFromQuestionTypeID failed: arg = %q", questionTypeID)
}

func (q *Question) parseComponents(questionTypeID string) error {
    mikanQT, err := ParseMikanQuestionTypeFromQuestionTypeID(questionTypeID)
    if err != nil {
        // mikanQTに未対応のQuestionTypeは処理しない
        return err
    }
    switch mikanQT {
    case QUESTION_TYPE_READING_UNIT_CHOICES:
        c, err := parseQuestionComponents[QuestionComponentReadingUnitChoices](q.RawComponents)
        if err != nil {
            return err
        }
        q.Components = c
    case QUESTION_TYPE_READING_CHOICES:
        c, err := parseQuestionComponents[QuestionComponentReadingChoices](q.RawComponents)
        if err != nil {
            return err
        }
        q.Components = c
    case QUESTION_TYPE_LISTENING_UNIT_CHOICES:
        c, err := parseQuestionComponents[QuestionComponentListeningUnitChoices](q.RawComponents)
        if err != nil {
            return err
        }
        q.Components = c
    case QUESTION_TYPE_LISTENING_CHOICES:
        c, err := parseQuestionComponents[QuestionComponentListeningChoices](q.RawComponents)
        if err != nil {
            return err
        }
        q.Components = c
    }
    return nil
}
これでJSONデータをmikanQT構造体へ変換できました。
なお、JSON型で必須属性などを指定できない部分はこのようにアプリケーションで担保しています。
func (t QuestionComponentReadingUnitChoices) IsQuestionComponent() {}
func (t QuestionComponentReadingUnitChoices) Valid() error {
    if t.Result == nil {
        return errors.New("result is empty")
    }
    // 文単のバリデーション 文単の解説画面がすべてHTML対応するまで後方互換を保つ必要がある
    if t.Result.Sentence == nil {
        if t.Result.Explanation == nil {
            return errors.New("result explanation is empty")
        }
        if t.Result.Explanation.Text == "" {
            return errors.New("result explanation text is empty")
        }
        if err := t.Result.Explanation.Type.Valid(); err != nil {
            return err
        }
        if t.Result.SentenceEN == nil {
            return errors.New("result sentence_en is empty")
        }
        if t.Result.SentenceEN.Text == "" {
            return errors.New("result sentence_en text is empty")
        }
        if err := t.Result.SentenceEN.Type.Valid(); err != nil {
            return err
        }
        if t.Result.SentenceJA == nil {
            return errors.New("result sentence_ja is empty")
        }
        if t.Result.SentenceJA.Text == "" {
            return errors.New("result sentence_ja text is empty")
        }
        if err := t.Result.SentenceJA.Type.Valid(); err != nil {
            return err
        }
    } else {
        if t.Result.Sentence.Text == "" {
            return errors.New("result sentence text is empty")
        }
        if err := t.Result.Sentence.Type.Valid(); err != nil {
            return err
        }
        if t.Result.Headline == nil {
            return errors.New("result headline is empty")
        }
        if t.Result.Headline.Text == "" {
            return errors.New("result headline text is empty")
        }
        if err := t.Result.Headline.Type.Valid(); err != nil {
            return err
        }
        if len(t.Choices) <= 0 {
            return errors.New("choices must be greater than 0")
        }
    }
    return nil
}
既存データとの並行運用のため、苦し紛れで条件分岐している泥臭い部分も残っています。
現状と今後の話
ここまでの作業をバックエンドチームのサイドプロジェクトとして進めてきました。
現時点ではTOEIC®教材に対しての移行が終わり、実際にmikanQTを利用した初の機能として初回模試という機能をリリースすることもできました。
初回模試は、TOEICを目標にするユーザに向けた、実力判定のための機能となっています。
TOEIC®のContents QuestionTypeをmikanQTに移行できた一方で、まだまだやるべきことは残っています。
ここ数ヶ月は別のプロジェクトが進行中のため、mikanQTの対応はしばらく先になりそうです。
この取り組みはバックエンドもクライアントも幸せになれるものなので、ぜひ時間を取って移行を進めていきたいと考えています。
おわりに
様々な教材を掲載しているmikanならではの課題について書きました。
完全なコードを出さずに説明している部分もあって読みにくかったかと思いますが、少しでもバックエンドチームの取り組みが伝わっていたら嬉しいです。
現在、mikanのバックエンドチームは2名ということで、バックエンドエンジニアを募集中です。
歴史的経緯にリスペクトを持ちつつ、より良い方向へmikanを改善していけるような仲間を探しています。
EdTech、英語学習、Go言語などのキーワードにピンと来たら、ぜひ以下の求人に応募していただけたらと思います。
いきなり応募というのもハードルが高いかと思いますので、カジュアル面談等もお待ちしております。その場合はDMをいただければと思います。
Jetpack ComposeのTextFieldで文字列を中央表示し、placeholderを表示しているときだけカーソルを左端に寄せたい
こんにちは、Androidエンジニアの @syarihu です。mikanでは副業メンバーとしてお手伝いをさせていただいています。
今回はJetpack ComposeでのちょっとしたTipsとして、TextFieldの中央にplaceholderを表示し、カーソルをplaceholderの左端に寄せる方法について紹介します。
実現したいこと
文章だけだと何を言っているのか分かりにくいと思うので、とりあえず最終的にどういう形にしたいのか、デザインを見てみましょう。

これはmikanの初回起動時に表示されるオンボーディング画面内のニックネーム入力フォームです。中央に「れもん」というplaceholderを表示し、その左端にカーソルが置かれています。
一見簡単そうに見えますが、これを実現するにはちょっとした工夫が必要です。
普通にやろうと思うとどのような課題があるのか、それをどう解決したのかを順を追って説明します。
Jetpack ComposeのTextFieldでplaceholderを中央配置したときの挙動
ComposeのTextFieldで普通にplaceholderを中央配置しようとすると、次のようなコードになります。
var nickname: TextFieldValue by remember { mutableStateOf(TextFieldValue()) }
Box(modifier = Modifier.padding(20.dp)) {
  OutlinedTextField(
    value = nickname,
    onValueChange = { textFieldValue ->
      nickname = textFieldValue
    },
    shape = RoundedCornerShape(8.dp),
    colors = TextFieldDefaults.textFieldColors(
      // ...
    ),
    singleLine = true,
    placeholder = {
      Text(
        text = "れもん",
        color = Color.hint,
        textAlign = TextAlign.Center,
        modifier = Modifier.fillMaxWidth(),
        fontSize = 16.sp,
      )
    },
    textStyle = LocalTextStyle.current.copy(
      textAlign = TextAlign.Center,
      fontSize = 16.sp,
    ),
    modifier = Modifier.fillMaxWidth(),
  )
}
これを実行すると、次のように表示されます。

このように、普通にやろうとするとテキストを中央配置している都合でカーソルがplaceholderの真ん中に表示されてしまうことが分かります。
これをどうにかカーソルだけ左に持っていく方法を考えてみます。
Jetpack ComposeのTextFieldでplaceholderを中央配置しつつ、カーソルをplaceholderの左端に持っていく方法を考える
カーソルの表示は入力された文字列に依存しているため、当然入力文字列が存在しなければカーソルの位置をずらすことはできません。また、文字列を入力すると通常のplaceholderの仕組みを使うことはできません。
そのため、通常のplaceholderの仕組みを使わないアプローチとして、TextFieldの入力文字列が空のときにplaceholderの代わりにコードから文字列を入力し、placeholderとして入力されている文字列があるときは入力文字列の色をplaceholderの色に変えてみることを考えました。
はじめに、placeholderの表示有無をshowPlaceholderとして持っておき、showPlaceholderがtrue(テキストが空)のときにテキストの色をplaceholder用に変えて、テキストが入力されたときにonValueChanged内でsuffixにあるplaceholderを削除して改変するようなコードを書いてみました。
var nickname: TextFieldValue by remember {
  mutableStateOf(TextFieldValue())
}
val showPlaceholder: Boolean by remember(nickname.text) {
  mutableStateOf(nickname.text.isEmpty())
}

Box(modifier = Modifier.padding(20.dp)) {
  OutlinedTextField(
    value = if (showPlaceholder) TextFieldValue(text = "れもん") else nickname,
    onValueChange = { textFieldValue ->
      nickname = textFieldValue.copy(text = textFieldValue.text.removeSuffix("れもん"))
    },
    shape = RoundedCornerShape(8.dp),
    colors = TextFieldDefaults.textFieldColors(
      textColor = if (showPlaceholder) Color.hint else Color.textMain,
      // ...
    ),
    singleLine = true,
    placeholder = {
      Text(
        text = "れもん",
        color = Color.hint,
        textAlign = TextAlign.Center,
        modifier = Modifier.fillMaxWidth(),
        fontSize = 16.sp,
      )
    },
    textStyle = LocalTextStyle.current.copy(
      textAlign = TextAlign.Center,
      fontSize = 16.sp,
    ),
    modifier = Modifier.fillMaxWidth(),
  )
}
これを実行すると、次のようになります。

この対応でカーソル位置を左に寄せることは実現できました。
しかし、placeholderから切り替わったタイミングで一文字目が自動で確定され、2文字目以降しか変換できなくなってしまいました。placeholderが変わったときにTextFieldが内部で持っているvalueと違うTextFieldValueが設定されてしまい、そのタイミングで1文字目が自動で確定されてしまうのだと思います。
また、次のようにTextFieldValueのcompositionを一文字目から明示的に指定するのも試してみました。
OutlinedTextField(
  value = if (showPlaceholder) TextFieldValue(text = "れもん") else nickname,
  onValueChange = { textFieldValue ->
        val newText = textFieldValue.text.removeSuffix("れもん")
      nickname = textFieldValue.copy(
      text = newText,
      composition = TextRange(0, newText.length)
    )
  },
これを実行すると次のようになります。

先ほどよりもさらにひどくなり、すべての文字列が未確定状態となっているものの、変換候補が表示されず別々の文字列として確定されてしまいました。
TextFieldValueは別の値に変えようと思うとプロパティが読み取り専用のためcopyすることになるのですが、copyすると値は引き継がれますが別のインスタンスが生成されます。
ユーザーが入力し、onValueChangedで通知された値をcopyしてTextFieldValueを別のインスタンスにしてしまうと、TextField内で保持しているものと違うTextFieldValueとなってしまうため、入力途中の文字列としては扱われなくなってしまうことがわかりました。
そのため、この方法ではカーソル位置を一番左にすることはできますが、入力を自然に行うことはできないため、このアプローチは使えないことがわかりました。
VisualTransformationを使って入力文字列が空のときの見た目だけ変えて、カーソルを常に左端に寄せつつplaceholderっぽいものを作る
若干諦めかけていたものの、ComposeのTextFieldにはVisualTransformationという仕組みがあることを思い出しました。
VisualTransformationは例えばパスワード入力時などに実際の入力文字列とは別に見た目だけマスクするなどの用途で使用できるものですが、そういった既に用意されているVisualTransformationとは別に、独自でVisualTransformationを作ることもできます。
これをうまく使って、入力文字列が空のときに見た目だけplaceholderっぽいものを表示して、なにか入力されたら入力文字列をそのまま表示してあげれば、実際の入力文字列に影響を与えずにうまく動作させられるのではと考えて試してみました。
実際に作ったVisualTransformationは次のようなコードです。
private fun placeHolderVisualTransformation(
  placeholder: String,
): VisualTransformation = VisualTransformation { text ->
  val showPlaceHolder = text.text.isEmpty()
  TransformedText(
    AnnotatedString(text = text.text.ifEmpty { " $placeholder " }),
    object : OffsetMapping {
      override fun originalToTransformed(offset: Int): Int =
        if (showPlaceHolder) 0 else offset

      override fun transformedToOriginal(offset: Int): Int =
        if (showPlaceHolder) 0 else offset
      }
  )
}
placeholderとして表示する文字列を引数にとる関数を作成します。入力テキストが空の場合は表示文字列をplaceholderに変えておきます。
originalToTransformedとtransformedToOriginalは入力文字列とTransformedTextでテキストの長さに違いがある場合にカーソル位置を調整するものですが、placeholderとして扱いたいため常に左端にカーソルがいくように、placeholderの表示中はoffsetを0として返すようにします。
あとは、TextFieldのvisualTransformationに設定しつつ、次のようなコードを書きます。
var nickname: TextFieldValue by remember {
  mutableStateOf(TextFieldValue())
}
val showPlaceholder: Boolean by remember(nickname.text) {
  mutableStateOf(nickname.text.isEmpty())
}

Box(modifier = Modifier.padding(20.dp)) {
  OutlinedTextField(
    value = nickname,
        onValueChange = { textFieldValue ->
      nickname = textFieldValue
    },
    shape = RoundedCornerShape(8.dp),
    colors = TextFieldDefaults.textFieldColors(
      textColor = if (showPlaceholder) Color.hint else Color.textMain,
      // ..
    ),
    singleLine = true,
    textStyle = LocalTextStyle.current.copy(
      textAlign = TextAlign.Center,
      fontSize = 16.sp,
    ),
    modifier = Modifier.fillMaxWidth(),
    visualTransformation = placeHolderVisualTransformation(placeholder)
  )
}
あくまで入力文字列の見た目を変えているだけなので、最初に考えたアプローチと同じようにテキストカラーはplaceholderの表示中はplaceholderの色に変える必要があります。
本来のTextFieldのplaceholderはvisualTransformationを使うことで不要になったので、placeholder引数の指定は削除しています。
これを実行してみると、次のようになります。

1文字目が自動で確定されることなく、入力した文字列がすべて変換対象となり変換候補も表示され、デザイン通りの見た目で自然に入力させることができました 🎉
おわりに
若干諦めかけましたが、なんとか期待どおりのUIを作ることができて良かったです。もし似たようなケースを実装することがあれば、VisualTransformationを試してみてください。
最後に、僕がお手伝いしているmikanでは正社員のAndroidエンジニアを募集しています。ご興味ある方は下記のリンクからぜひご応募ください!
また、話だけでも聞いてみたい!カジュアル面談してみたい!という方も、応募メッセージにその旨を書いてお気軽に送ってください!よろしくお願いします!
CircleCIのセキュリティアラートに対応した時の振り返り
株式会社mikan バックエンドエンジニアのgamiです。最近はFactorioにハマってしまい黙々と工場を建設しています。
2023年の年明けにCircleCIからセキュリティアラートが通知され、Twitterのトレンドになるほど多くの皆さんから反応があったことをご存知でしょうか?
mikanでもCircleCIを利用していたため、シークレットのローテーションなどの対応を実施しました。
この記事は社内用に残した対応履歴のドキュメントを社外用に書き直し、振り返りを付け加えたものです。
TL;DR
- 結果的にmikanのシステムには問題ありませんでした。
- CircleCIをアクティブに利用していたプロジェクトは1つだけだったため、CircleCIで組んでいたワークフローは他のプロジェクトに合わせてGitHub Actionsへ移行しました。
タイムライン
2023/01/05 11:34 JST メール受信
CircleCI Security Alert - 4 Jan 2023 - Rotate any secrets stored in CircleCIという件名でメールが来ました。
早速反省点ですが、この時点ではすぐに対応を開始することができませんでした。
この日はmikanの期初のタイミングで全体的にバタバタしており、加えてチームメンバーの休暇や突発的な採用業務などが重なったためです。
本来であればメールの内容を確認した上で対応の優先順位を判断すべきでしたが、後回しにしてしまいました。
2023/01/05 19:42 JST 関係者への共有
関係者へセキュリティアラートの共有。
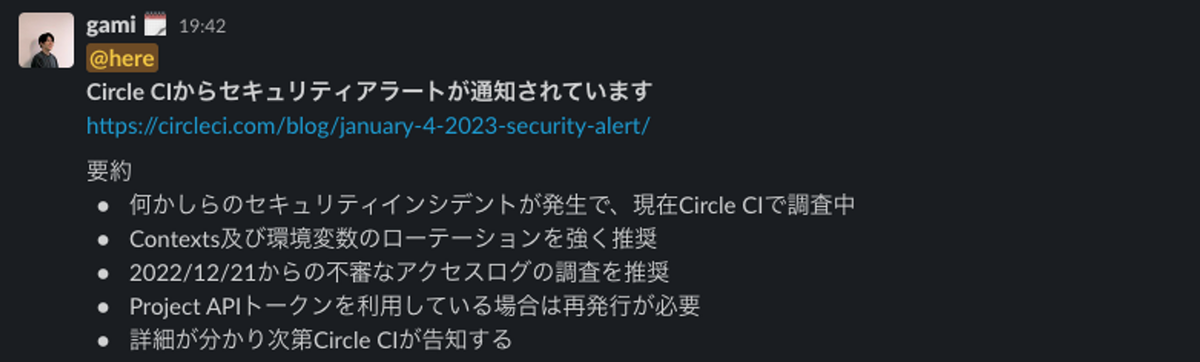
これからオペレーションを実施するには時間が遅いので、翌日に対応を行うことにしました。
しかし翌日もバックエンドチームのメンバーは休暇予定だったため、代表のkazuさんに協力を依頼しました。
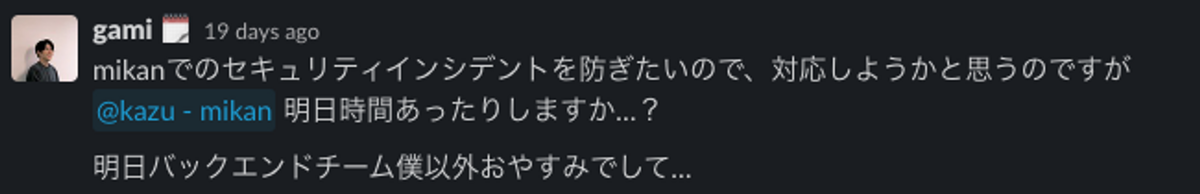
翌日を逃すと3連休に入ってしまい、対応がかなり遅れるリスクがありました。
四半期の始まりで各プロジェクトの方針レビューなどがある忙しいタイミングで快諾していただけて本当に良かったです。
2023/01/05 20:27 JST 事前準備
対応方針の書き起こし
翌日に作業実施が決まったため、下記のざっくりと対応計画を立てました。
- シークレットのリストアップ
- 1.の中から不要な鍵を特定し削除
- 使用中のシークレットのうち、他のシステムでも使っているものをリストアップ
- 3.で見つけたシークレットを更新
これはよく見ると2番は後回しでも良いです。実際に鍵が漏洩して悪用されていた場合、鍵を無効化することが優先されるため、いかに早く4番を完了させるかが重要でした。
実際の作業では2番よりも4番を優先できたので良かったと思います。
シークレットのリストアップ
mikanでCircleCIが有効になっているプロジェクトは2つありました。mikanで管理しているリポジトリは40件を超えているため、そこから比較するとかなり少ない件数です。
後日CircleCIからシークレットをリストアップするツールが公開されることになりますが、この時点では件数も少なかったので手作業で以下を確認しました。
- Environment variables
- Contexts
- Deploy Key
ここで見つけたものはスプレッドシートでキー名を管理し、翌日の仕分けに利用しました。
2023/01/05 PST CircleCIからの追加情報
CircleCIから追加情報がありました。
(https://circleci.com/blog/january-4-2023-security-alert/ の Security update 01/05/2023 の部分)
ここではシークレットのローテーションに関する対応手順が書かれていたため、まずは該当の有無を確かめました。
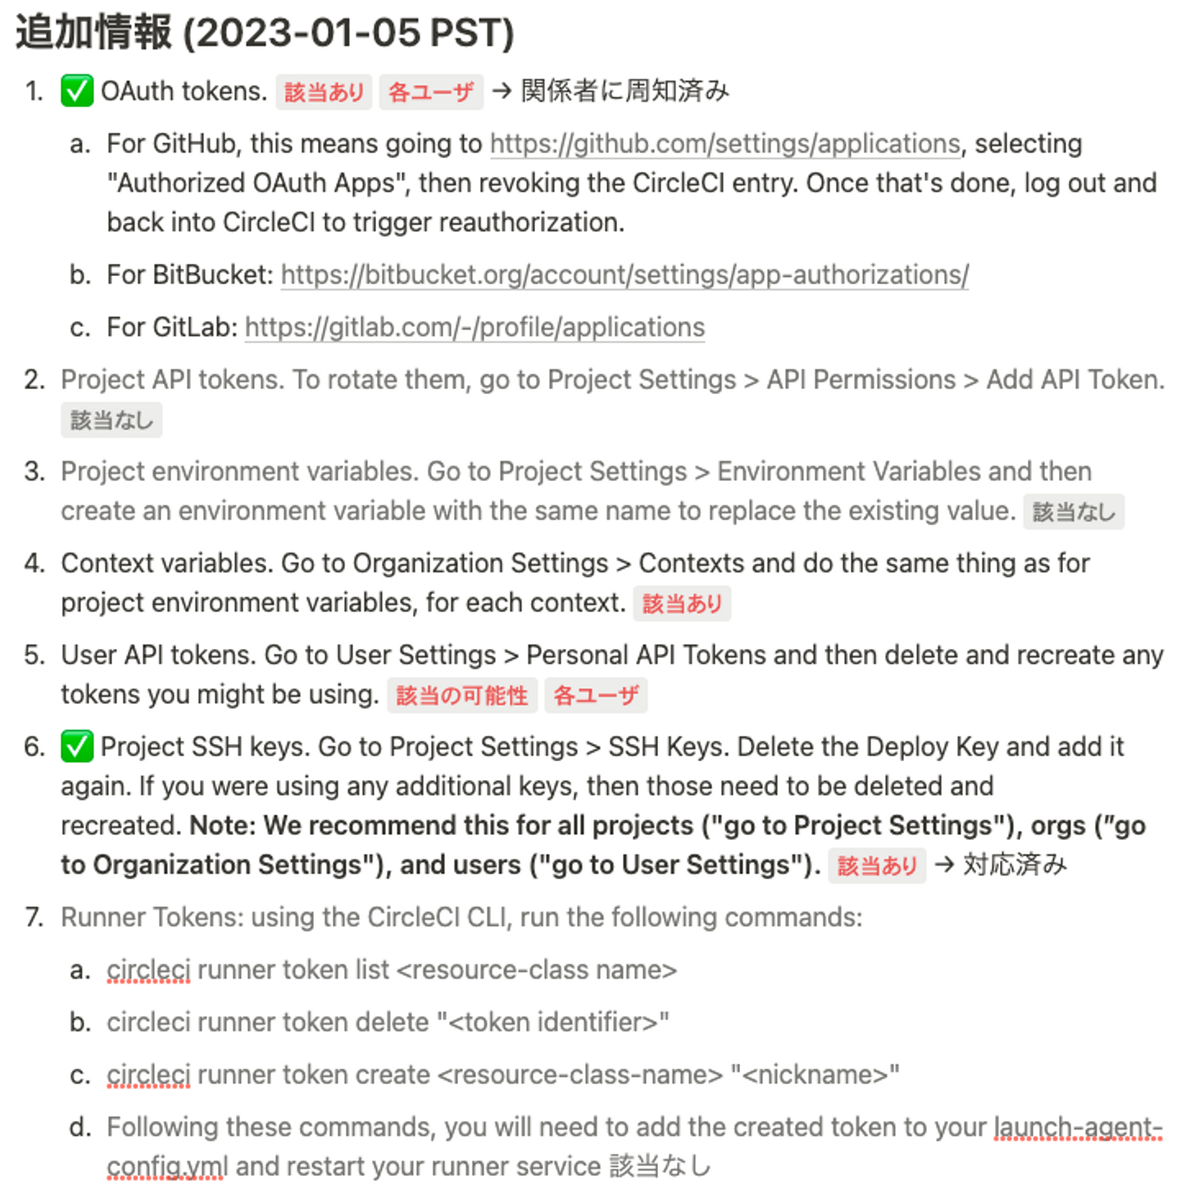
この調査にあたり、CircleCIのコンソールで私の権限では見れないものに関してはkazuさんにも非同期で確認してもらいました。
2023/01/06 11:57 JST ローテーションの開始
一人で対応可能なOAuthトークンのリフレッシュ及びDeploy Keyの差し替えのみを実施しました。
Deploy Keyの差し替えは少しだけ罠がありました。
コンソールに出ていたエラーは
{
	"message":"Not Found",
	"documentation_url":"https://docs.github.com/rest/reference/repos#create-a-deploy-key"
}
となっており、GitHubのドキュメントが案内されていたため、GitHubの権限を確認しました。
案の定権限が足りていなかったため、インフラ作業用の強い権限を持つアカウントで該当リポジトリの権限設定を修正してからリトライしました。(具体的には、Adminロールに個人アカウントだけが含まれている状態だったため、チームを招待しました。)
これにより、GitHub側でSSH Keysが更新されたことを確認しました。
2023/01/06 13:37 JST CircleCI-Env-Inspector
念のため、CircleCIから提供されたツールを実行してみました。
そのまま動かすとエラーになったため軽くパッチを当てたところ、前日にリストアップした内容に問題ないことが分かりました。
2023/01/06 15:33 JST 追加の調査と手順書作成
ローテーション対象の絞り込み
リストアップした環境変数のうち、明らかに利用されていないものがいくつかあったため、本当に利用されているものだけを絞り込むために調査を行いました。
作業内容としては、対応するリポジトリに対して、CircleCIで設定している環境変数を呼び出している箇所をgrepして確認するという地道なものになりました。
この調査の結果、対象範囲をかなり絞り込むことができました。
ローテーションの具体的な手順書を作成
上記調査をもとに、アプリケーションの動作確認を含むローテーション作業の手順書を作成しました。(AWSの一部サービスを利用するIAMが対象でした。)
- IAMで認証情報を新規作成
- 検証用の新たな環境変数を作り、1の情報をコンテキストにセット
- 検証用の新たな環境変数を参照するようにアプリケーションを修正
- アプリケーションをデプロイ
- IAMが利用されたことと、AWSのサービスを利用する処理が問題なく動作することを確認する
- IAMの古い認証情報を削除
- 既存の環境変数を置き換え
- 4を再実行
- 5を再実行
上記を各環境 (開発環境、ステージング環境、本番環境) で実行します。
2023/01/06 16:00 JST ペアでローテーション実施
軽く背景の共有と状況報告を行い、kazuさんとペアで作業を開始しました。
3連休を控えた週末に何度もデプロイをすることになりましたが、一緒に見てもらえたことで焦らずに作業することができました。
不具合なく作業を完了できたのは、ペアで作業したからこそだと思います。
2023/01/06 18:00 JST 頃 サービスアカウントの停止
ひととおりデプロイ作業が完了したため、Firebase CLIのトークンを発行しているサービスアカウントを停止しました。
振り返ってみると、トークンは真っ先に無効化しておくべきだったと思います。Firebaseのサービスアカウントを乗っ取られていた可能性があるためです。
mikanはFirebaseに依存したシステムがいくつかあるため、悪用されたときの影響はかなり大きくなってしまいます。
2023/01/10 16:30 JST ログ調査
シークレット漏洩の可能性のあるサービスはAWSとFirebaseの2種類のサービスだったためログの調査を実施しました。
AWSの方は、1つのサービスの許可しか与えられていないIAMのアクセスキーだったため、該当のサービスのログを確認し、不審なものがないかを探しました。
Firebaseの方は影響範囲が広かったため、まずはFirebaseのGUIコンソール上で異常がないかを確認し、その後APIの利用状況などを調べました。
これらの調査の結果を踏まえ、mikanへの問題はなかったと判断しました。
2023/01/18 17:40 JST ワークフローをGitHub Actionsへ移行
mikanでCircleCiを利用しているプロジェクトは2つあり、そのうち1つはメンテナンスが終了していました。
そのため、アクティブにCircleCIを利用しているプロジェクトは1つのみとなり、他のリポジトリのほとんどはGitHub Actionsを利用していたため、今回ローテーションを実行したプロジェクトもGitHub Actionsへ移行することにしました。
GitHub Actionsへ移行するついでにGitHub OIDCを利用するようにワークフローを修正し、よりセキュアな状態に組み替えました。
また、先日発表されたGitHub Actionsの構成変数を利用し、機密性の低いものは暗号化しないことで有事の際の調査に役立つようにしました。
終わりに
新年早々大変な作業となりました。本件の対応に当たった各社及び個人の皆様もお疲れ様でした。
mikanでは結果的にCircleCIの利用を辞めてしまいましたが、CircleCIの今回の案内は非常に誠実だったと感じており、好感を持ちました。
CircleCIで実際に何が起きたのかといったレポートも公開してくれています。
これを機に、mikanのセキュリティの甘い部分に関しても改めて話題に挙がるようになってきました。
少ない人数で事業を拡大させつつ守りも盤石にしていかなければならず、一筋縄には行かないかも知れませんが、一つずつ着実に進めていこうと思います。
以上、CircleCIのセキュリティアラート対応の振り返りでした。
2022年Androidエンジニアとしてやったことと今後について
こちらはmikanのアドベントカレンダー24日目の記事になります。
23日目は @hoshitocat から、「負債を計画的に返済していくために、Backendチームでやっていること」でした。 技術的負債は必ず起きていくものなので、負債と向き合うことは必須だと思います。みかんバックエンドチームでの向き合い方がわかる内容で、Androidチームも以前はやっていたんですけど最近負債解消に向き合えてないところがあるので、もう少し明確にやっていきたいと改めて思いました。
mikan で Androidエンジニアをやっている@zukkeyです。
最近は、犬か猫を飼いたくて物件探しをする毎日です。
賃貸のままにするのか、戸建てを思い切って購入するのかに悩んでいます。日々、検討に検討を加速させています。
今回は、今年自分が関わってきたmikan Androidの振り返りをしながらアプリの変化をお見せし、今後どうしていきたいかについて紹介させていただこうと思います。
今年やってきたことの振り返り
New Card & Test Redesign
mikan Android版は長らくカード画面とテスト画面が古いデザインのままでした。
RealmからFirestoreへ刷新するという巨大プロジェクトが動いている中、細々とカード学習画面とテスト学習画面のリデザインプロジェクトをやっていて、実は新しいデザインに変わったのは今年なんです!(リリースされたの今年だったのかー、と自分自身が一番驚いています。もはや遠い昔の話に感じます。)
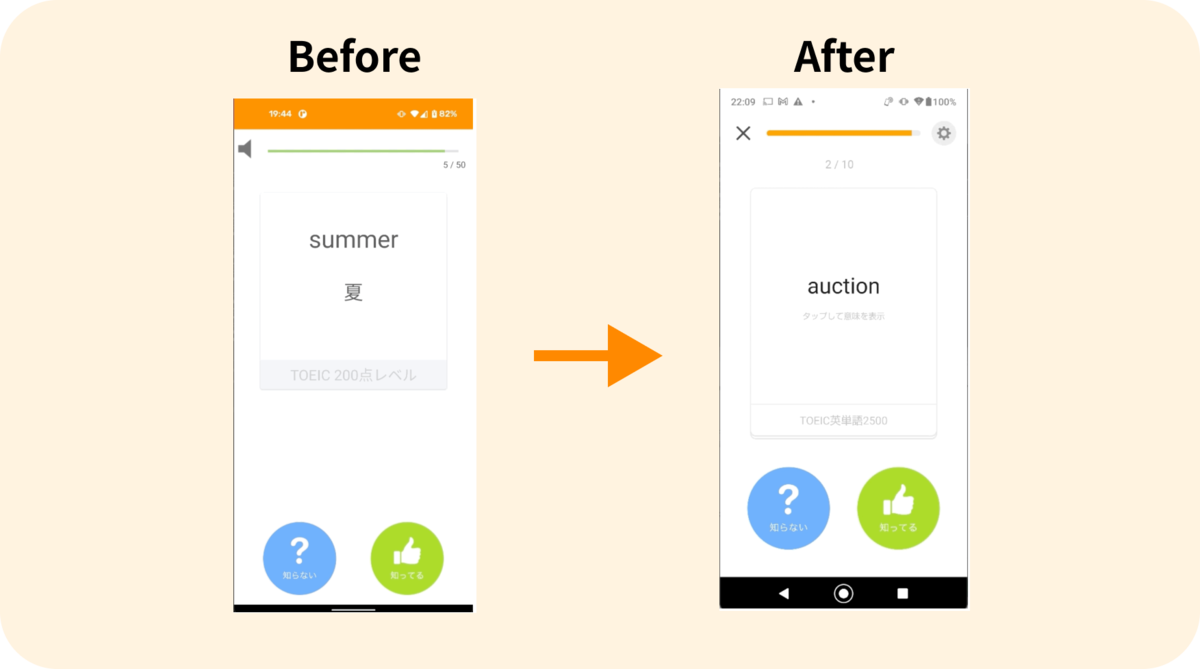
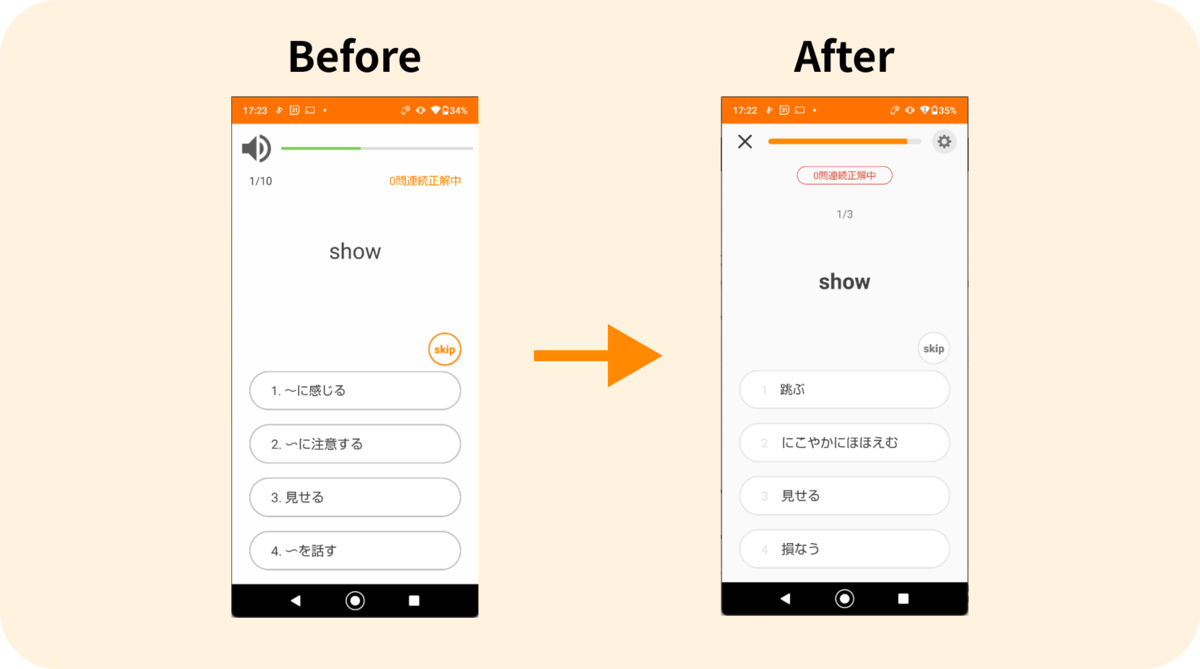
去年から進めていたプロジェクトだったので、無事にリリースできて嬉しかったです。
カード学習の方は特に表示領域が変わったので、以前よりは学習しやすくなっていると思います。
New Subscribe Plan View
今はもうさらに新しい課金プラン画面が登場したので、非常に寿命が短かったのですが、実は課金画面も新しくなっていたんです。
以前はシートが出ていなかったんですけど、より課金のプランがわかりやすいような表示に変わっていました。
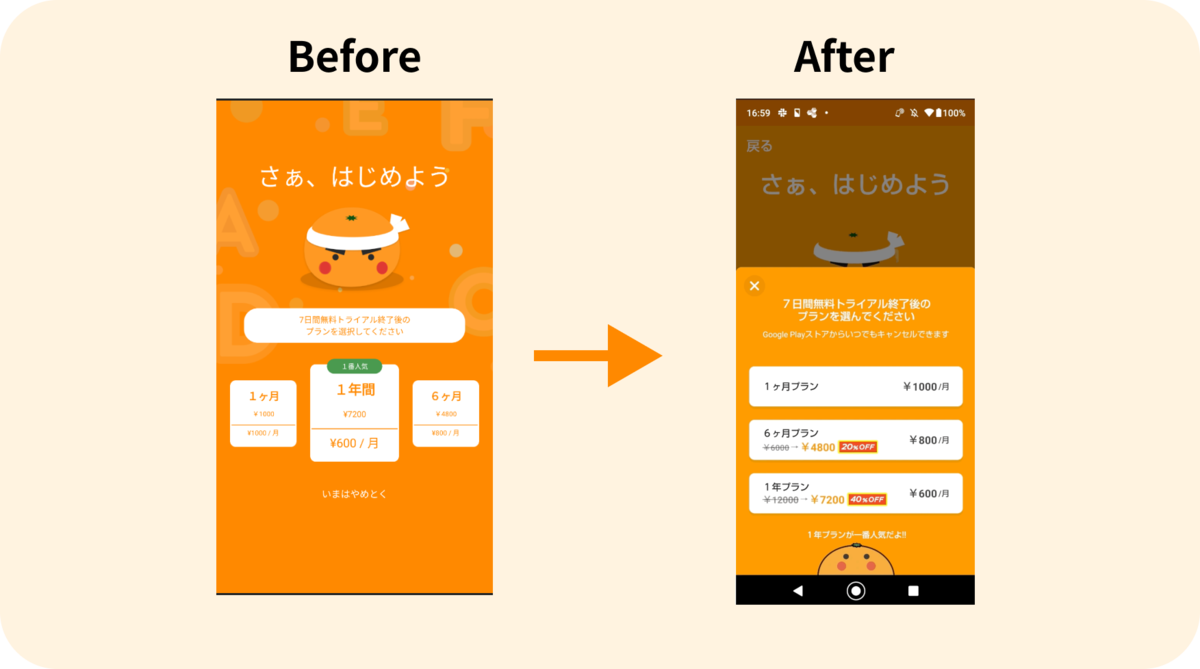
そういえば、こんなこともやっていたなと懐かしく思いますw
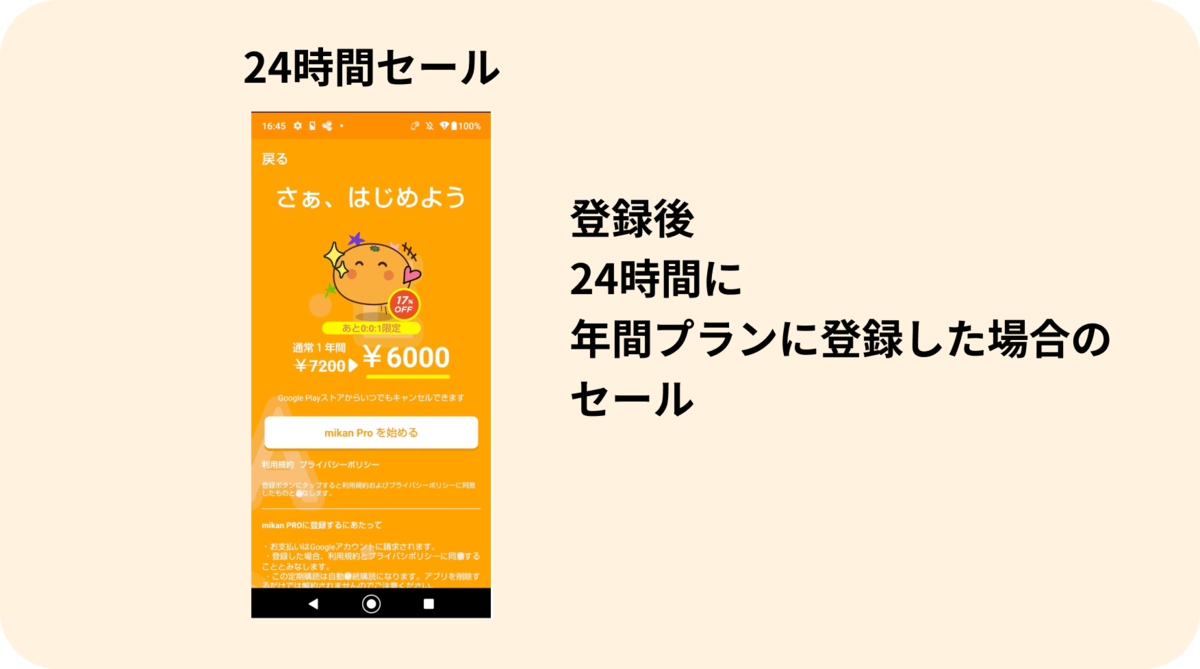
24時間セールが入ったのもこの時でした。この頃から徐々にAndroidはiOSの背中を本格的に追いかけていました。
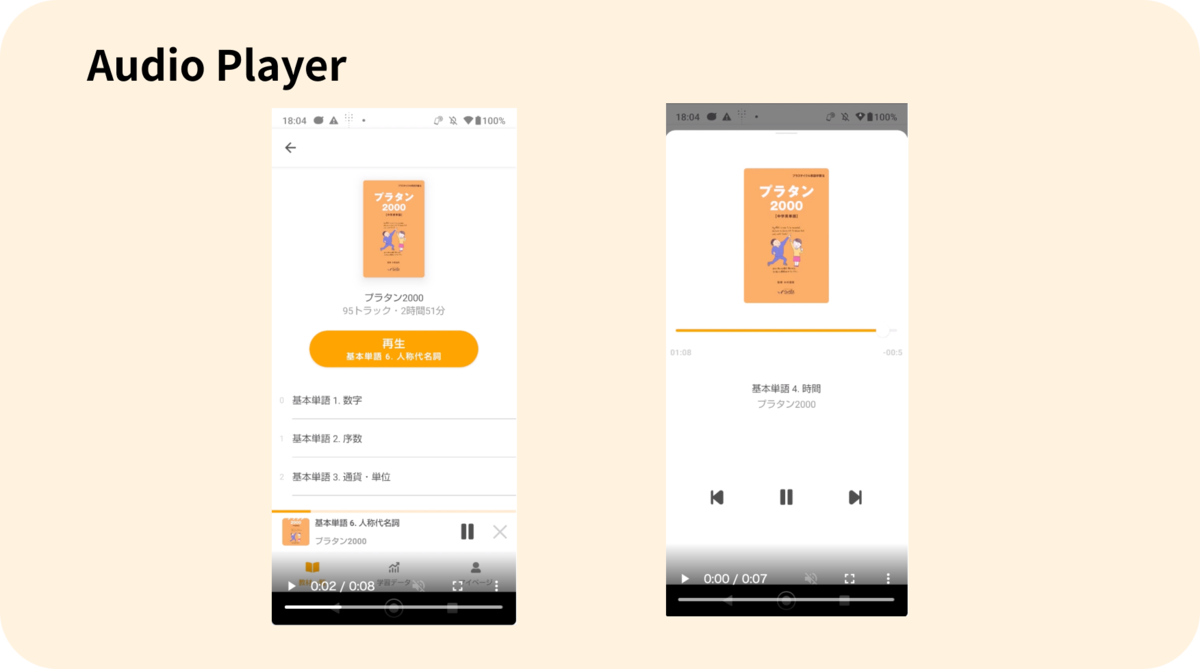
Audio Player
実は初Compose&ExoPlayer導入をしたプロジェクトでした。どちらかといえば、試験導入に近いフェーズでした。
ExoPlayerもComposeもよくわからない状況で、とりあえず公式ドキュメントとサンプルをみて手探りで進めていました。
ExoPlayerもComposeもドキュメントは充実していると思います。ただ、このパターンの実装の経験者が社内にいなかったことと、当時はComposeのサンプルがなかったので、UAMPのサンプルを一番参考にしつつ、自分なりに考えて組み合わせていくということをやっていました。
もともと考えていたアーキテクチャの構成もあんまりマッチしないので、一から考え直しだな〜、と頭を悩ませていましたね。
Audio Playerの一番初期は「プラタン2000」のみ利用できる機能になっていました。
当時は期限が決まっていたので急いで対応する必要があり、未経験ながらExoPlayerとComposeを組み合わせて導入したのがいい思い出です。
自分自身音声周りの実装については初めてやることだったので、なかなか不具合を出してしまい、QAチームには負担がかかってしまいました。
優秀なQAチームにたくさんQAしていただき、バグを直して直して直しましたので、いい状態に仕上げられたのではないかと思います。
DB Project a.k.a Darwin
DB Projectというのは、元々mikanアプリはRealmを使っていたので、データベース周りをRoomとFirestoreを使う方針に切り替えるというデータベース刷新のプロジェクトのことです。mikan社内ではDarwinという名前をつけて呼んでいます。
一応自分も担当していたので、上記にあげたプロジェクトを進めながらリリース後もお問い合わせいただいた件を対応していたりしました。
読み込み速度が遅いというお問い合わせをいただいていたので、リリース後も速度周りの改善を進めていました。
どうやら、オフライン切り替え判定部分が上手くいかずにFirestoreを参照しにいっていて読み込みがうまくいかないとか、オフラインオンラインで使っているうちにデータの不整合が起きてしまう問題とか、さまざまな現象が起きてワタワタして四苦八苦していたのがいい思い出です。
Android側も直したり、バックエンドチームにScriptを作っていただいたりして、皆で対応をしていました。
まだ、問題がある部分はあるので、後ほど記載する「今後について」で紹介いたします。
Toeic Project a.k.a Honda
Toeic Projectは、TOEIC問題演習の形式に対応する問題演習機能を新規追加するプロジェクトです。mikan社内では、Hondaと呼んでいます。
もともと、mikanは英単語アプリだったのですが、英語アプリへ移行するという方針に変わり、その上でiOSでは既に対応していた機能で、AndroidもiOSに追いつくべく、問題演習機能の導入をやっていこうというプロジェクトでした。
Audio Playerでやっていて試験導入とはまた別に、Composeをがっつり導入して副業の方とも相談させて一緒にやっていただきながら、いろいろな意見を聞いて実装を進めていきました。
当時は適宜わからない部分はヒアリングもしつつ、iOS側も実装が大変そうということもあったので、自分でiOSのコードを読みにいったりして参考にしたりしました。
また、副業の方の依頼用タスクを作成したり、自分でも実装したりと、慌ただしくも学びの多い期間でした。
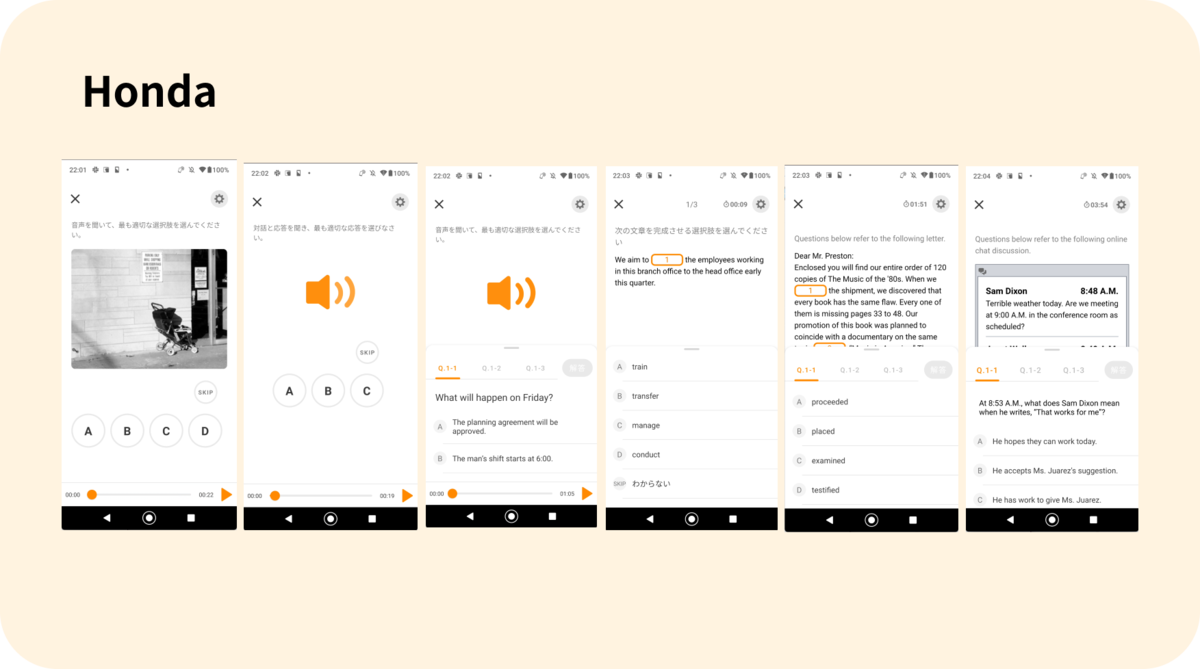
Toeicの問題演習機能は、全部で6パターン存在するので、そのパターンごとに学習画面、学習解説シート、学習結果画面を用意する運びとなりました。
なかなか実装工数もかかる大きいプロジェクトだったと思います。
Composeと仲良くなれるいい機会でした。
Toeic Project v2 a.k.a Enhancement of teaching materials
Toeic Projectのv2として、教材充実化というプロジェクトもありました。
最初に出したバージョンでは、mikanオリジナルの教材にしか対応していない形で実装していたので、どの教材がきても同じパターンであれば利用できるようにする実装と、この当時はなかった(先程の画像には載ってしまっているのですが、)リーディングの右上にある学習推奨時間の導入を合わせて行うというプロジェクトでした。
裏で課金対応をしてもらっていたので、自分はこちらの課金プランに応じた教材の充実化をする対応をやっているという流れでした。
このプロジェクトのおかげで、またComposeの実装に詳しくなれたのではないかと思います。
Phrase and Sentence Project
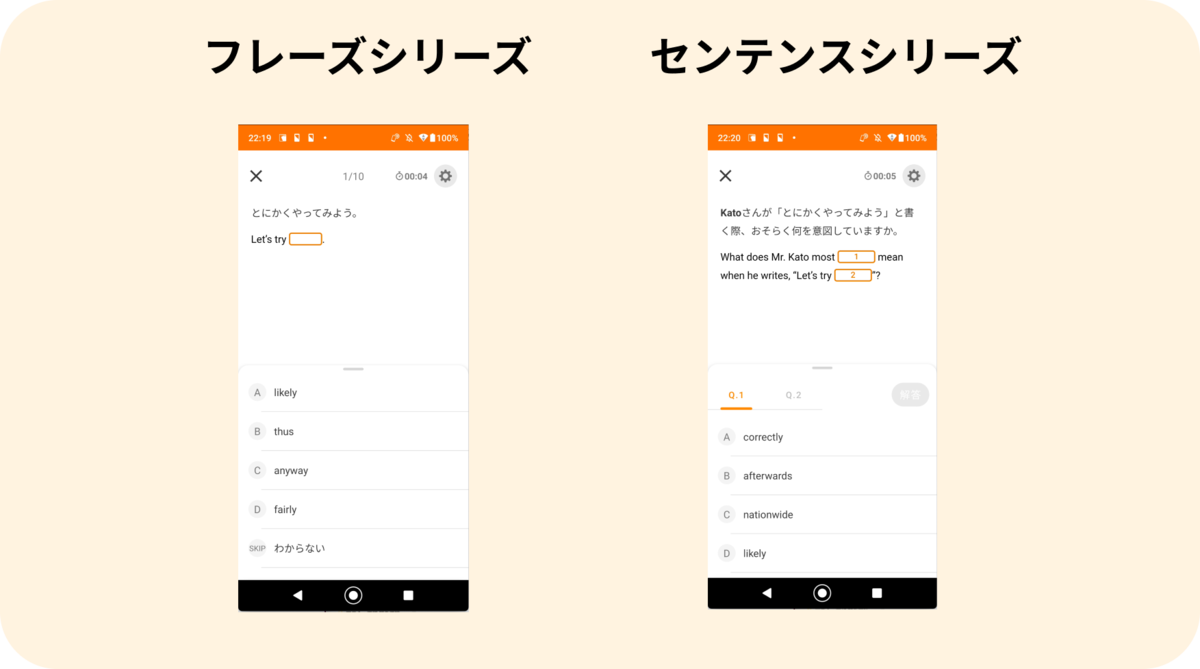
Phrase and Sentence Projectは、「金のフレーズ」「金のセンテンス」といったフレーズシリーズとセンテンスシリーズへの例文学習機能を実装するプロジェクトでした。
このタイプの教材だけに、元々あるカード学習機能、4択テスト機能に加えて、例文機能を追加するという内容でした。
一見すると、Toeicの問題演習機能に激似しているので、サクッと終わるかなと思っていました。
実はそれが罠で、裏側とのロジック部分が異なるので、若干テコ入れをしてあげないといけない、ということがおきました。成長痛を感じたプロジェクトでした。
また、このタイミングで、設定画面のリプレイスを行いました。
教材詳細画面から歯車のアイコンをタップして遷移できる設定シートをComposeで新規で作り替えるという対応も行いました。また一つ画面を新しくすることができました。
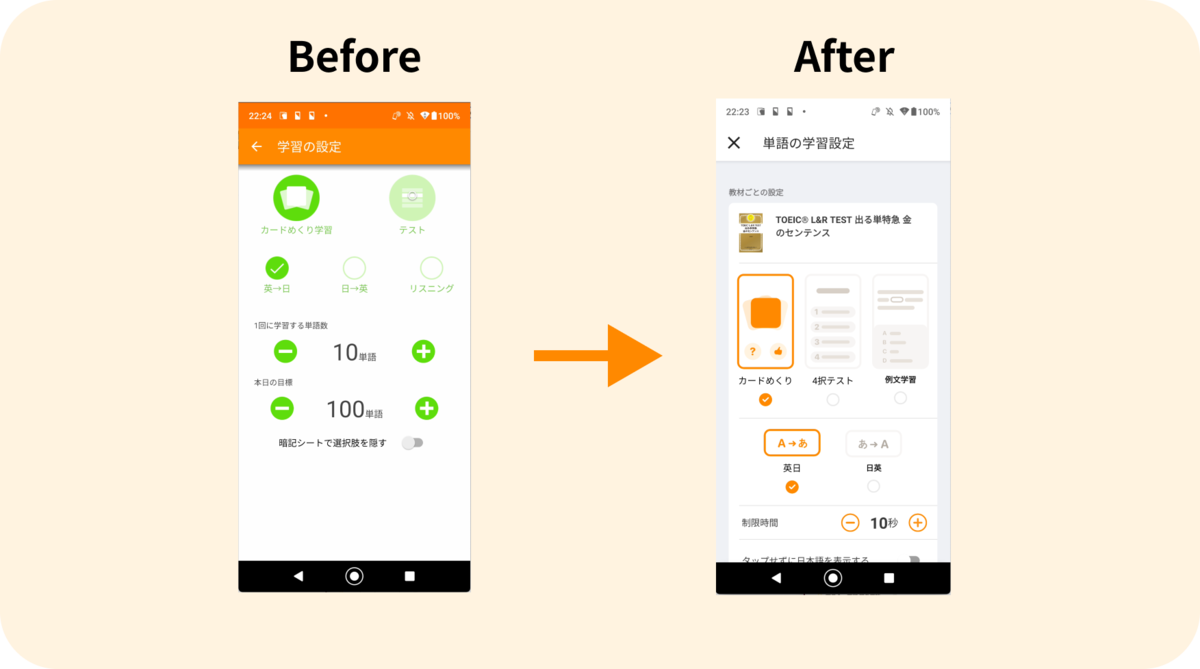
実はこの上で、カード学習、4択学習、問題演習、例文学習画面それぞれの設定シートも新しくなっていたりします。
結構いろんな画面をComposeで組んでみて、ComposeはUIを組みやすくて非常に早く簡単にやりたいことを実現できる(肌感)ので、なんだかもうAndroid開発だいぶやりやすくなったなぁと一番感じたプロジェクトでした。
このほかにも、いくつか対応したことがあるのですが、まだ表に出る機能ではなかったり、ちょっとしたことだったりするので、割愛とします。
振り返りのまとめ
今年は、ひたすらアップデートしてiOSの背中を追いかけるために黙々と実装するという1年でした。マラソンで例えるなら、遠く離れてしまい中継先のテレビから見えなかった姿が、もう後ろ姿は見える、というところまできたのではないかと思います。
mikan Androidは少ないメンバーでありながらもComposeで画面を次々と実装していったり、ExoPlayerを導入したり、自分は主にやってはなかったんですがGraphQLを導入したりと、新しい技術を取り入れつつ、いろんな機能を実装していくことができたのではないかと思います。
個人としては、Androidアプリに限らずWebの実装をお手伝いしたり、タスクを依頼したりなど去年とはまた違ったことをやっていました。
やってみる中で、自分は人に依頼するのは苦手ですが、もくもく実装するのは得意な方で新しい分野を学ぶのも楽しくやっていけているので、プレーヤーとしてやっていく方がいいのかもしれないな、と感じた1年でした。
今後について
この1年で、ぶっちゃけmikan Android結構変わったんじゃない?という気持ち、あります。
でも、実はまだまだやりたいことがあります。
自分が考えていて直近対応したいことは、3つです。
- 速度改善
- 機能差分実装
- ダークテーマ
今のところ、通信環境問題で学習がうまくいかないお客様が一定いらっしゃるので、すでに取り組んではいつつも、やりたいといいつつ時間が思うように割けずにいたので、来年こそはより優先して対応したいと思います。
また、iOSとAndroidの機能差分がまだあります。まだ教材によっては対応しなければならないことがあるので、それらの差分吸収をしてさらに多くの教材を多くの方に使っていただき、アプリと英語を通して人生の可能性を広げるキッカケ作り、やっていきたいと思います。
あとは、実は裏ではひっそりと進んでいるダークテーマ対応、(途中から止まってしまっていたのですが、)やりたいですね。
ダークテーマを待ち望む声もありますし、最近では標準に近い機能と思いますので、なるべく早く取り掛かっていきたいところではあります。(もしくは、相方がやってくれるのかもしれないので、楽しみにしています。)
さいごに
今回はmikan Androidでやってきたことの振り返りを通して、mikan Androidの進化の過程をお見せできたのではないかと思います。
mikan に興味を持ってくださって、一緒に最高のAndroidアプリを作ってくださるエンジニアやデザイナー募集しております!!
ぜひぜひ、下記リンクよりご応募くださいませ!!!
負債解消は計画的に〜Backendチームの取り組みをご紹介〜
こちらはmikanのアドベントカレンダー23日目の記事になります。
22日目は @3izorin から SaaSのプロトタイプを作るのにNotionがおすすめな件 でした!
プロトタイプと聞くと、画面があって簡単なワイヤーフレームをイメージしてしまうのですが、情報整理がされていて、それを元に議論するツールと捉えることもできるなと勉強になりました。情報設計する際は上記を参考に Notion を活用してみてはいかがでしょうか?
こんにちは。mikanでBackendエンジニアをしております。 @hoshitocat です。
23日ということで今年も残りわずかとなってきましたね。余談ですが、先日家に友人が来てくれたのですが、部屋が乾燥しているから加湿器使ったほうが良いとオススメされたので、何か買おうかなと思っております。何かオススメのものがあればぜひ教えてください!
さて、今回の記事では、負債の解消にチームでやっていることを紹介しようかと思います。負債の解消に悩んでいる方や、そもそもそこへの取り組みが全くできていなく、課題感を持っている方はぜひ参考にしてみてください。
はじめに
いきなりですが、技術的な負債に関しては皆さんどのように捉えておりますでしょうか?
私は以下を参考にしております。
技術負債はチームおよびそのメンバーが成長する上で必ず発生しうるものであり、むしろチームが成長している証拠であると思っています。チームやメンバーが成長するにつれて、以前書いたコードと自分がこれから書こうと思っているコードの乖離が広がっていきます。そのため、この差を埋める作業が必要になります。しかし、この差を埋める作業はプロダクトを前進されるもの(成長させるもの)ではありません。そのため、事業を伸ばすための開発時間を確保することを優先しすぎてしまうことがあると思います。
弊社のサービス英語アプリmikanは650万ダウンロードを超えており、2014年にリリースされて以来、いろんな機能が追加されてきました。私が入社したのは2019年ですが、今ではBackendチームも3人に増え、よりリリースのサイクルが高速化しました。しかし、3人に増えたことで、施策を試すスピードがあがったことや、開発の規模もこれまで以上に大きなものになってきたことなどがあり、今のシステムとチームおよびメンバーの技術負債はより広がっていきました。
負債解消のために導入した仕組み
mikanでは、事業をより成長させるため、英単語アプリから英語アプリへ進化してきたように、直近のやっている施策はより攻めの施策が多く、ガンガン進化しています!
一方で負債解消には手がつけられていない状況が続いており、このままだとドンドン負債が溜まっていってしまう状況となっていました。
そこで、Backendチームでは強制的に負債を解消するための仕組みを導入しました。
負債解消Day
月に一回オフィスに集まって、負債解消だけをやる日を設けました。これを実施する上で、他チームメンバーには以下の2つに協力してもらっています。負債解消をやる上でノイズになってしまうからです。
- Slackでの反応が遅れる
- MTGは入れない
負債解消Dayの実施には、必ず事前準備をしています。負債解消Dayではチーム全員が負債解消の時間とするため、より時間を有効活用する必要があります。
事前準備では、そもそも今月の負債解消やる必要あるっけ?ということから、負債解消でやるべきタスクを一覧し、その上から順番に優先度づけを実施、その順番に着手していくというのをやります。
優先度は最も早く効果が現れるものを選ぶようにしています。 なぜ優先度をこのようにつけるかといいますと、前提として、負債という性質上より早く解消した方が、開発効率や施策の進めやすさ(技術的制約が少なくなる)に影響するものばかりだと思っています。
その中で、より早く効果が現れる = 直近やっている開発orこれからやろうとしている施策に影響の出るもの ということであり、施策の順序は事業成長の優先順位から決められているはずなので、負債の解消もそこに紐づいた順位をつけられる方が良い考えているからです。
また、効果が現れる とは、開発効率といった単純なものもありますし、これから事業成長のロードマップ上、解消しておいた方が良い技術的な問題の両方だと思っています。したがって、技術的には負債となっているけれど、ロードマップに乗ってこないような部分の改修は優先度は低く、ロードマップ上必ず開発が進んでいくような部分に関しては優先度高く改修する必要があると捉えています。
実施するタスクが決まったら、それに必要な情報を集めたり、先に当日のスケジュールまでざっくり決めています。スケジュールが決まっているとやることや動き方に迷わなくなるので、当日の動きがより円滑になるからです。
スプリント毎に負債解消ポイントを10~20%程度設ける
Backendチームでは1週間を1スプリントとし、スプリントの区切りのタイミングでは、次のスプリントのタスクを洗い出したり、見積もりをしています。
そのときに、ベロシティに合わせて、10~20%程度負債解消していこうという取り決めをしています。このルールを設けることで、負債解消Dayではやらないような細かい負債の解消も定期的に解消していくことができます。
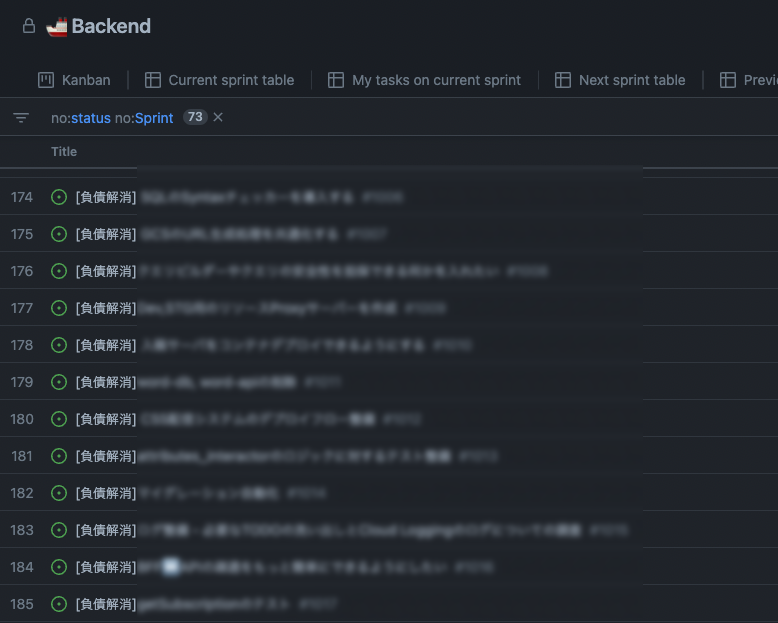
負債Backlogを作って負債を記録する
負債は気づいたタイミングで、タスクボードに記録するようにしています。Backendチームはタスク管理をGitHub Issueを使っていますが、負債解消タスクも同様に記録しています。
負債解消Dayやスプリント計画のときに、記録されているタスク一覧から、ピックアップするだけでよいので、負債になっていることを忘れることもないし、負債解消しようと思ったときに、そこから選択するだけで良くなるため、負債解消までのハードルを下げることができています。
負債解消の妥当性について
負債解消をする上で最も気にしなければならないことは、事業成長の速度を鈍化させてはならないということです。そこで、負債解消をしても生産性が鈍化していないことを証明できれば、負債解消の時間を確保することの納得感が得られると考えました。また、上記でやってきた取り組みの効果をより実感できると思います。
やっていることは至ってシンプルで、以下の3つです。
- 開発時間の計測
- 時間計測には、 clockify というツールを導入しています。簡単に計測できるし、 チーム全体やメンバーなどのさまざまな条件で、集計結果をみることができるので便利です。
- タスクへのポイントづけ(計画と実績の両方)
- 計画と実績の両方あることで、見積もりの妥当性を検証できます。
- 生産性の指標として four keys を導入
- 長くなるので、これは後ほど紹介記事書きたいと思います。
Backendチームの1時間あたりの消化ポイントが下がっていないことや、four keysの指標から、事業成長の速度を鈍化させていないことを計測できるようになりました。
まとめ
今回は、負債解消のために弊社のBackendチームがやっている取り組みについてご紹介させていただきました。
負債解消は仕組みかしないとなかなか取り組みが難しいところではありますが、仕組みさえ導入してしまえば、着実に解消を積み上げていくことができるので、ぜひ参考にしていただけたら幸いです。
さいごになりますが、弊社では一緒に働く仲間を募集しています。もし、ご興味のある方は以下のリンクからでも良いですし、私にDMしていただいても良いので、お気軽に声かけてください!
特にデザイナーの方募集中です!!
ご興味ある方は何卒お声がけください!!社内のデザイナーにもお繋ぎします 🧑🎨
それでは、また次回もお楽しみに。
mikanの実例で学ぶGoogle Play Billing Library V5
はじめに
こんにちは!mikanでAndroidエンジニアをしている、gumiojiです!
こちらはmikanのアドベントカレンダー 18日目の記事になります!
1つ前の17日目の記事は@chiakiの「CSがQAやったら意外とメリット多かった話」でした!
CSでmikanに入社したchiakiさんがQAに転身したのですが、ほんとに観点が鋭くて日々すごく助かってますw
余談ですが、この頼もしいQAチームのおかげで、上位プラン導入はリリース後、驚くほどに何も問題がなくて逆に怖いくらいです…w
今回mikanでは、今までの通常プランのmikan PROの上位プランにあたる、PRO PLUSを導入する際にAndroidの課金ライブラリである、Billing Libraryを最新のv5に同時にアップデートしたので、その際の辛かったことポイント2点を軽い備忘録として残そうかなと思います!
PRO PLUSとは? どういった背景で導入したの?という方は前回の僕の振り返り記事のPRO PLUS対応欄をご覧ください!!
対象読者
これからAndroidでBilling Library v5を新規で導入したい方、v4利用中で移行したい方
Billing Library
Google Playの課金システムにアプリから楽にアクセスできるLibraryと思ってもらえたらと思います!2022年12月16日現時点ではVersion5が最新です!
いつも最新版は2年間のサポートとなりますので、v5は再来年の5月までには利用しておきましょう!
新規導入の方
サクッと確認したい方、手元にPCなどがない場合は公式の導入ガイドを見ていただければと思います!
既存から移行する方
こちらも移行ガイドを用意してくれているので、それに従いましょう!
共通: 手を動かしながら確認したい方
お時間がある方、手元にPCがある方はCodelabsが用意されているので、実際にコーディングなどを通じて学んでいくと良いと思います
補足: Google codelabsとは?
Googleが用意している、各お題毎にガイド付きのチュートリアルを用意したハンズオン形式のコーディング体験ができるコンテンツです!
codelabs.developers.google.com
それでは実際に何が辛かったのかの紹介をしていこうと思います!
実装でハマった部分
つらみ1: 新しい構造の扱いにくさ
v5で一番大きな変化といえば、課金モデルが変わったことです。
Before: v4まで
- 1Subscription(aPlan + aOffer)
After: v5から
- 1Subscription
- aPlan
- aOffer
- bOffer
- bPlan
- ・・・
- cPlan
- aPlan
図で表現すると以下のような形になり、左側がBeforeで、右側がAfterとなります
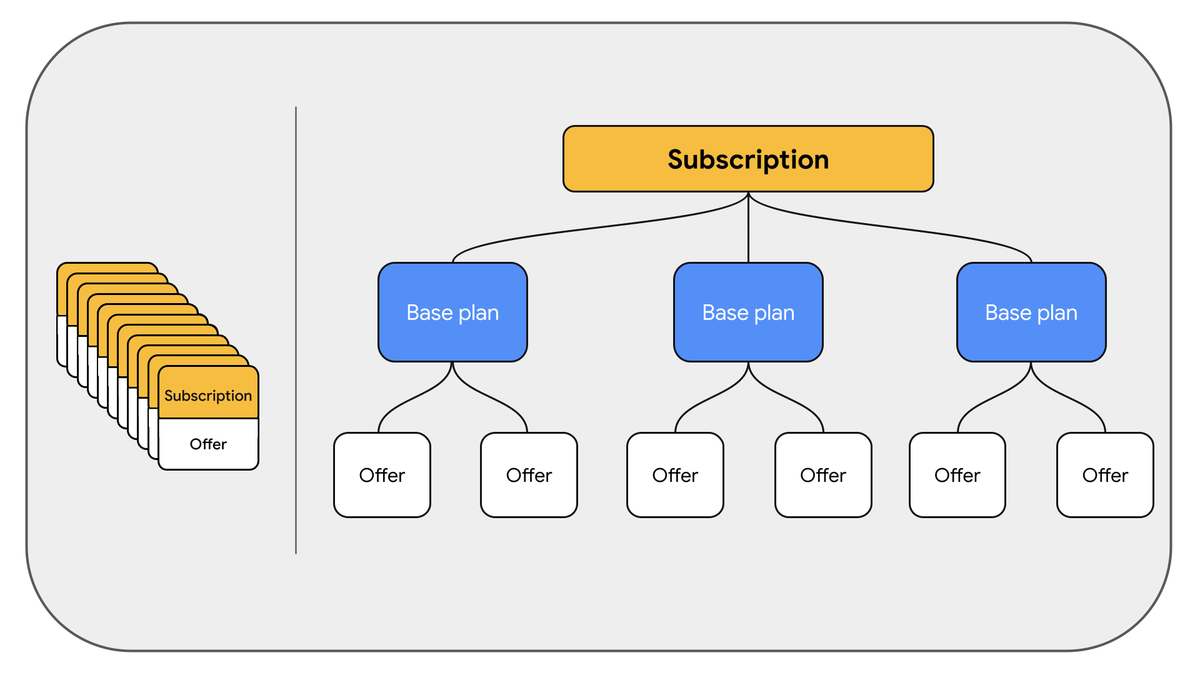
Beforeは全てが1つの塊として作成されてしまっていたため、柔軟性がなく、別期間を用意したい、特別な割引などを別途提供したいなどの際に1つ1つ新しいSubscriptionを作成してました。
ex.
- Subscription
- mikan PRO 1ヶ月
- Subscription
- mikan PRO 6ヶ月
- Subscription
- mikan PRO 1年間
- Subscription
- mikan PRO 1年間
- 半額セール
- mikan PRO 1年間
Afterからは階層的な構造になったことで、柔軟性が増しました。
今までと変わらず、一番上にSubscriptionが存在し、その下に期間などを表すBasePlanが存在し、最後に割引や無料トライアル等といった提供を行うOfferが存在します
ex. 以下のような形になり、新しい期間やセールなどをを追加したい、変更したい場合に追加することが可能です
- Subscription
- mikan PRO
- 1ヶ月
- 無料トライアル
- 6ヶ月
- 無料トライアル
- 1年間
- 無料トライアル
- 半額セール
- 1ヶ月
- mikan PRO
お〜!いいやん!って思ったんですけどね、BasePlanとかOfferの取得どこ???
そんなものはないぜ!!!全部tagで指定しろよな!!とのことらしいです。。。。。
「t…tag….? なんですかいそれは…?」
BasePlanやOfferなどはコード上で取得をする際にtagを使って取得するように作られています。
実際にplay consoleの画面を見てみましょう!画像内のタグという箇所になります。
BasePlan
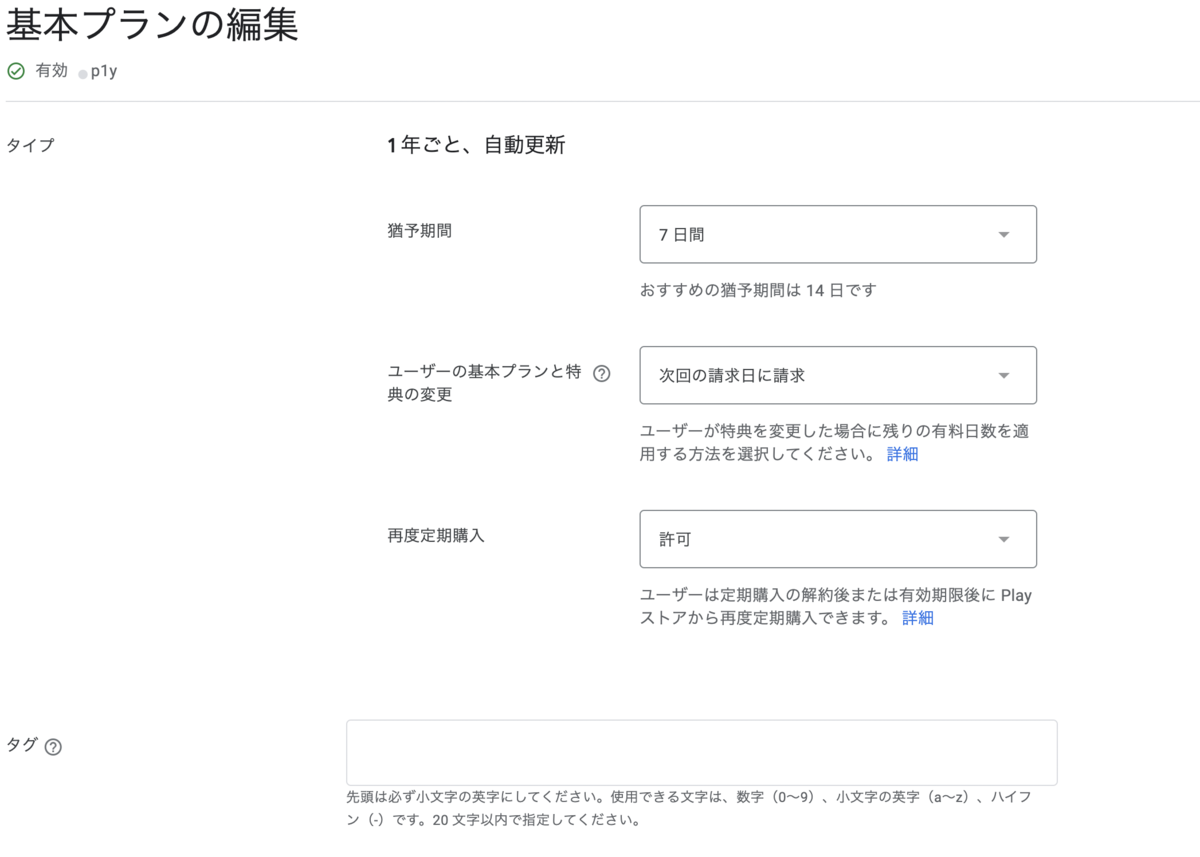
Offer
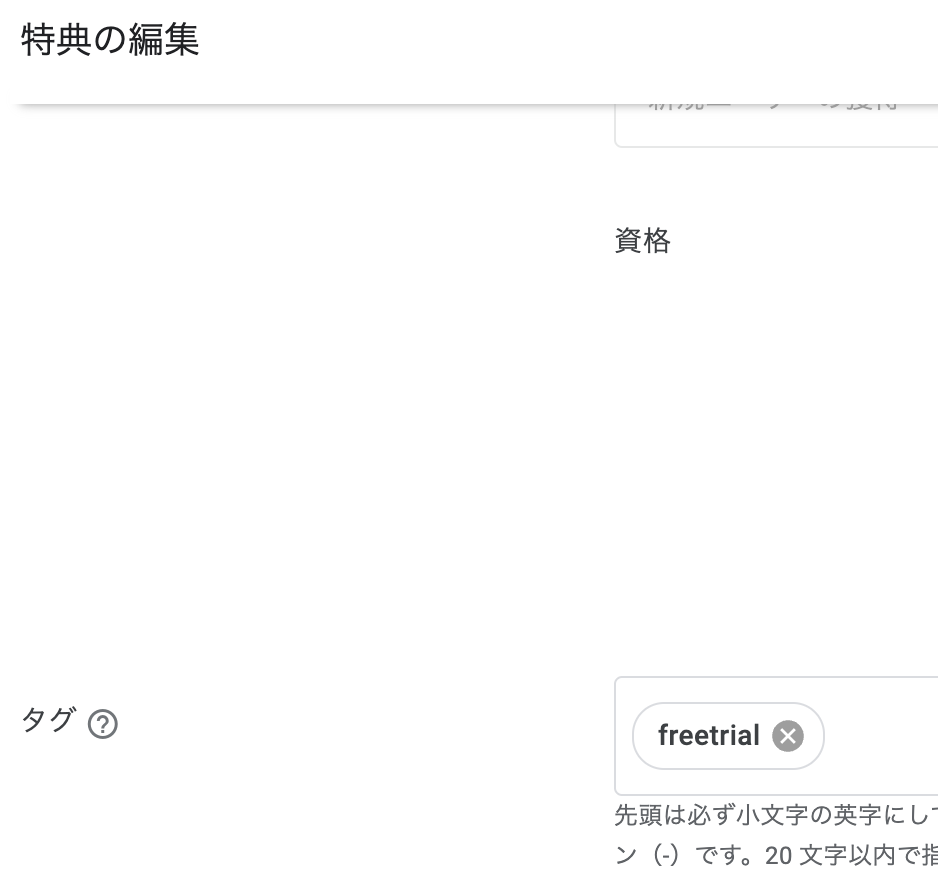
ここまではまだいいんですが、BasePlanのtagを指定したのはいいけど、そのtagはどこで使うんですかい?? どこで指定するんですかい?? なくないですか?? Googleさん??()
これに関しては、ProductDetails.SubscriptionOfferDetailsのofferTagsにbasePlanもofferのtagもまとめて入ってくるみたいです….そんなこと1mmも書いてないんですけど….(せめて分けるか分かりやすいのを用意してほしかったよ…offerって書いてますやん…)
この辺どこに情報が隠れてるかというと、Codelabsのsample githubに書いてあります
上記sampleより、以下指定されたtagをofferDetailsの中から該当するものがあるか、あればそのofferDetailsを返すものです
   /**
     * Retrieves all eligible base plans and offers using tags from ProductDetails.
     *
     * @param offerDetails offerDetails from a ProductDetails returned by the library.
     * @param tag string representing tags associated with offers and base plans.
     *
     * @return the eligible offers and base plans in a list.
     *
     */
    private fun retrieveEligibleOffers(
        offerDetails: MutableList<ProductDetails.SubscriptionOfferDetails>,
        tag: String
    ): List<ProductDetails.SubscriptionOfferDetails> {
        val eligibleOffers = emptyList<ProductDetails.SubscriptionOfferDetails>().toMutableList()
        offerDetails.forEach { offerDetail ->
            if (offerDetail.offerTags.contains(tag)) {
                eligibleOffers.add(offerDetail)
            }
        }

        return eligibleOffers
    }
上記のtagを渡してる呼び出し元は以下で、tag = MONTHLY_BASIC_PLANS_TAG って書いてありますね….
viewModel.buy(
  productDetails = it,
  currentPurchases = currentPurchases,
  tag = MONTHLY_BASIC_PLANS_TAG,
  activity = activity
)
う〜〜〜〜ん、めんどくさいっ()
mikanではどうしたか
実は既存の課金アイテムはv5がリリースされた際に強制的に以下のような新しい形に強制変換されており、新規で追加するプランではあったのですがこの形に寄せました!
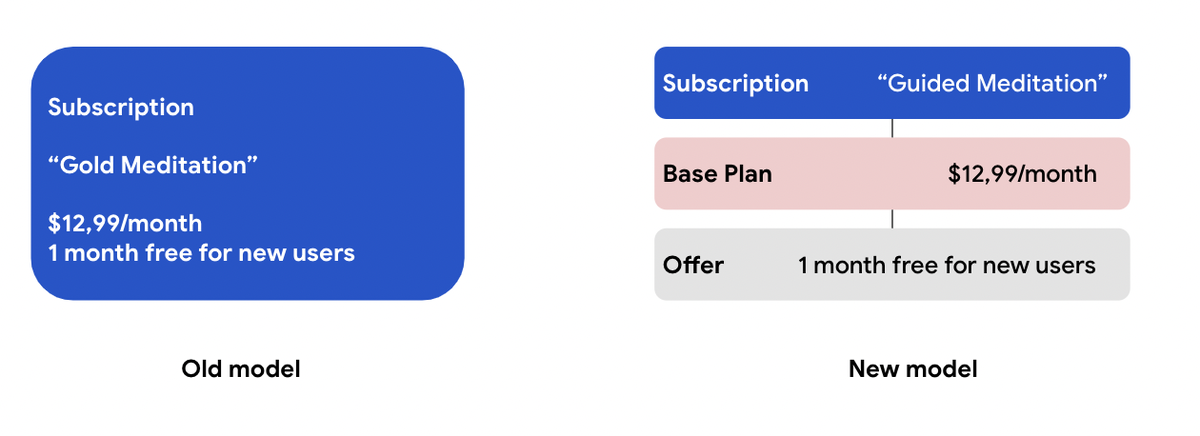
理由は扱いにくかったのとプランはそんな頻繁に追加はしないためです。
Offerは頻繁に追加したくなると思うので、そこだけ恩恵を受けれれば良いと考えました。
そのため、今回新しく追加したPRO PLUSには本来は3つのbasePlanが存在しますが、1Subscription: 1BasePlanとして扱ってるため、3つのSubscriptionとして作成しています!
つらみ2: Offerの融通の効かなさ
今回新たに追加されたOfferの選択ですが、こちらはBillingFlowParams.ProductDetailsParams.BuilderのsetOfferTokenにofferDetails.offerTokenを渡してあげることで指定できます!
先程上記で紹介したように選択すべきofferをtagを利用し、複数のofferDetailsから見つけ出して上げる必要があります。
val eligibleOffers = emptyList<ProductDetails.SubscriptionOfferDetails>().toMutableList()
offerDetails.forEach { offerDetail ->
  if (offerDetail.offerTags.contains(tag)) {
    eligibleOffers.add(offerDetail)
   }
}

return eligibleOffers
見つけたofferのtokenをbillingParamsのofferTokenに渡すのですが、offerなんて提供してないよ!だからいらないんじゃない??って方も空でいいので呼び出してあげてください。じゃないと機能してくれません
val billingParams = billingFlowParamsBuilder(
                    productDetails = productDetails,
                    offerToken = offerToken // 必ず呼ぶんじゃぞ
                )
なんか動かないな〜と思ったら、空でよいので呼び出してあげてください
→ ちなみに2022/08時点では、空をセットした場合は内部でoffer適用含め、最も安い価格になる条件になってました
このofferTagなんですが、消化した後も反映されるまでに少し時間がかかり、流れてくるのが混乱を招きました
→ 現時点ではこの辺りが改善されてる可能性もあるので、ご了承くださいm
offerはtokenだけを渡して、後はよしなにplay consoleがハンドリングしてくれるので一度消費していたら、実際の金額請求に関しては問題ないのですが、offerを提供しているのか? もう提供済みなのか? のLogなどを取りたかったため、この辺りは少し困りました。
→ これに関して、金額も一緒で複数のフェーズに分かれて、全部流れてきてしまい、反映されるまではoffer消費していてもoffer提供価格の金額が流れてくることがありました
じゃあ、バックエンドに頼って、バックエンド側でLogを送ってもらry
→ offer提供かどうかなんて判断できひんで^^
・・・・
mikanではどうしたか
あまり良くないとは思いますが、以下のようにしました
- 無料トライアルはアプリ単位で1回のみなんで、起動時にplay storeの履歴を確認し、1度でも購入してるかをみる
- 限定オファーもアプリ単位で1回のみなんで、起動時にplay storeの履歴を確認し、1度でも対象のItem群の内のどれか1つでも購入してるかをみる
この状態で条件を満たさない限りはofferTagを選択させないという状態にすることで消費されたかどうかを実現させています。
また、先程も述べたようにdefaultだと最低価格計算になってしまうため、offerを未適用にさせるという処理も追加する必要がありました。
→ 限定オファーの条件を満たしてないけど、まだ消費してない場合といったビジネス上の条件が存在する場合に当てはまります
実際のoffer選択の処理は以下のようにしています
var selectedOfferDetails: SubscriptionOfferDetails? = null
productDetails.subscriptionOfferDetails.orEmpty().forEach{offerDetails->
if (selectMode != null) {
        offerDetails.offerTags.forEach{tags->
if (tags.contains(selectMode.offerTag)) {
                selectedOfferDetails = offerDetails
            }
}
} else {
        if (offerDetails.offerTags.isEmpty()) selectedOfferDetails = offerDetails
    }
未適用 = 通常価格の場合はofferTagsが空っぽのため、空っぽのofferDetailsをセットして返してあげることで実現できてます!!
この辺りのofferのいい感じの処理の仕方、何かいい方法を知ってる方いれば、よろしくお願いします!!!
スペシャルサンクス
今回、mikanのBilling Libraryをv5にアップデートでき、無事何事もなくスムーズに上位プランであるPRO PLUSを導入できたのも、業務委託で手伝ってくださってるsyarihuさんのおかげです!
課金基盤の準備、アップデート作業、v5の調査や実装過程のアドバイスなどをしてくださってました!改めて、本当にありがとうございます!
おわりに
いかがだったでしょうか? まだ最新版に上げてないよ~って方や、これから使ってみようかなという方の参考になればと思います!
さて、mikanでは最高の英語アプリを共に作っていける仲間を常に探しております!(特にデザイナー…!!)
お気軽にTwitterでも下記のHERP経由でもご連絡ください。主はSplatoonが大好きなのでSplatoon面談もWelcomeです!
明日は@yocchanによる、「なぜ英語を勉強するのか-私が考えるmikanで人生の可能性が広がる理由」です!お楽しみに!
